Why your local LLM feels dumber than it is
forum.level1techs.com原文 ↗
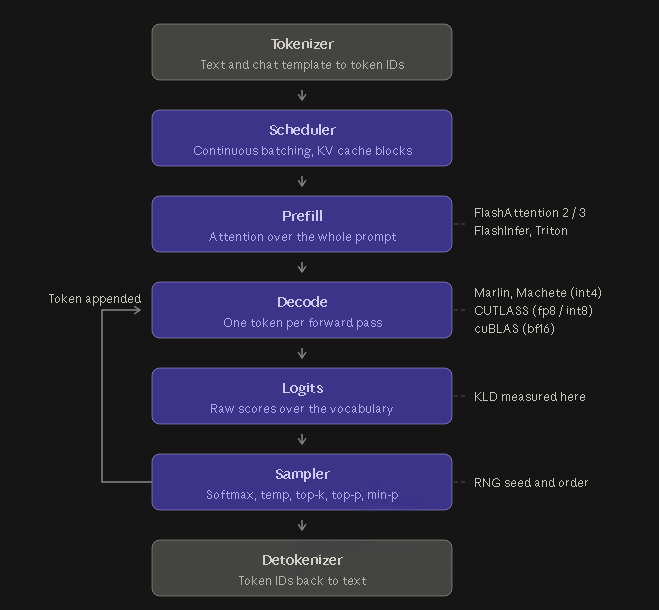
论坛作者在约 100k token 的真实工具工作流上拆开 attention backend、KV cache、量化、NCCL 和硬件差异,发现同一权重也会走出不同 logits。int4 KV cache 可复现地导致工具调用失败,NVFP4 在 88k 上下文约有 50% token flip;更刺眼的是只切换 CUDA kernel 就可能把 Cisco 的正确命令变成错误命令,说明本地部署需测“运行时组合”而非只看模型卡。
–浏览
评论 · Comments