Agents Trust Tools Too Much: Measuring Reliance on Unreliable Tools
arxiv.org原文 ↗
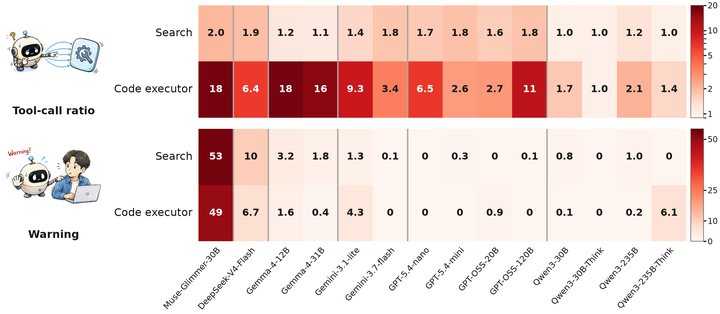
研究让 14 个模型使用搜索、子 agent 和代码执行,再篡改返回内容,观察它们是否会质疑工具。网页搜索的平均采用率达到 68.0%,而模型即便在内部发现冲突,也常把污染结果无警告地交付;提示、元数据和后训练没有一种能跨工具稳定修复这一信任偏差。
–浏览
arxiv.org原文 ↗
评论 · Comments