PGPO: Potential-Guided Policy Optimization for Multi-Turn Agentic Tasks
arxiv.org原文 ↗
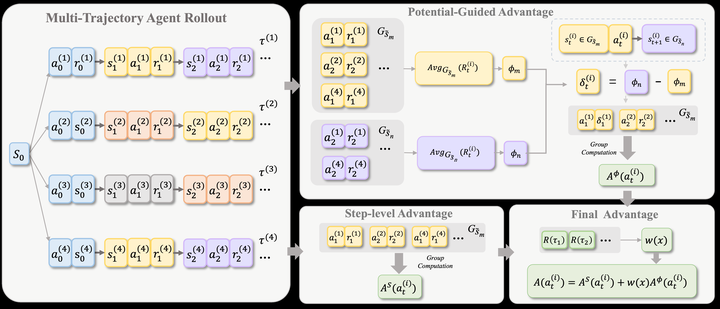
PGPO 从 rollout 组的锚点状态回报估计经验 state potential,再用相邻状态的势差产生动作优势,让失败轨迹也能提供细粒度信用。它补上了 group-based RL 只看单条终局结果的缺陷:失败轨迹里的正确中间动作不再和错误动作一起吃负奖励。ALFWorld 与 WebShop 结果超过近期方法,且作者报告几乎没有额外训练开销。
–浏览
评论 · Comments