ActiveSaddler: Automated Curriculum Learning for Agent Harness Optimization
arxiv.org原文 ↗
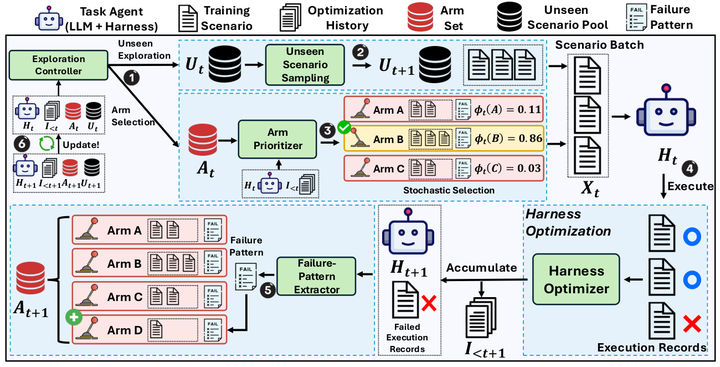
ActiveSaddler 将训练场景选择视为随 harness 演化的非平稳 bandit,并为动态实例化的优化目标挑选反馈样本。它改变的是反馈分布而不只是更新规则:当提示、工具接口或控制逻辑已变,下一轮最有价值的失败案例也会随之变化。
–浏览
arxiv.org原文 ↗
评论 · Comments