Where Scientific Search Agents Fail: Decision-Checkpoint Auditing of Exposure and Inspection Attempts
arxiv.org原文 ↗
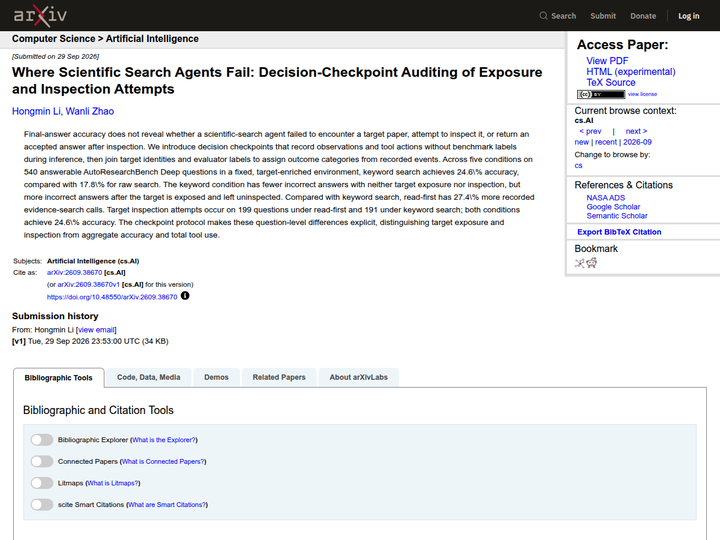
研究把搜索时的观察、工具动作和目标身份在事后对齐,区分 agent 没遇到目标、遇到却没打开、打开后仍判错三类失败。540 道 AutoResearchBench Deep 可答题中,关键词搜索准确率 24.6%,原始搜索 17.8%;read-first 多发出 27.4% 证据搜索调用,却与关键词条件同为 24.6%。这种检查点记录让“工具调用更多”与“真正检查了证据”不再被一个总分掩盖。
–浏览
评论 · Comments