DRACO: Fine-Grained Credit Assignment with Dynamic Rubrics for Long-Horizon Agent Training
arxiv.org原文 ↗
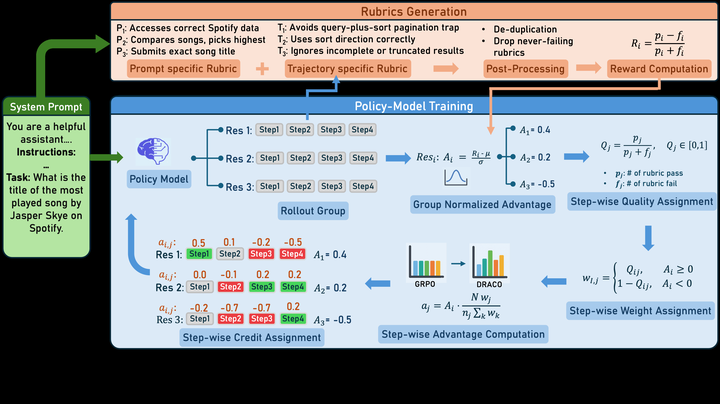
DRACO 将动态 rubric 的整轨迹评分闭式分摊到产生相应证据的步骤,作为 GRPO 的逐步优势,不需要额外归因网络或程序 verifier。AppWorld 比基础模型高 15.9 分,比稀疏真实奖励训练高 5.3 分;在没有 frontier judge 的 Tau-Bench 上仍保留 5.3 分增益,表明信号密度本身可改善长程学习。
–浏览
评论 · Comments