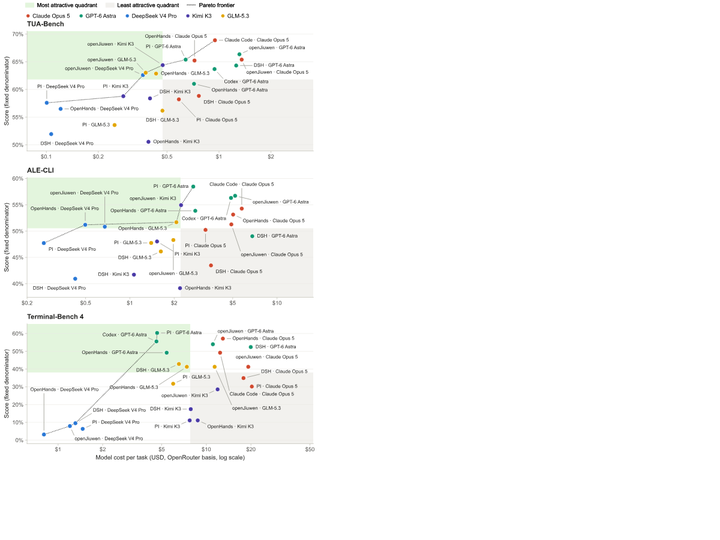
返回本期 · Back to 2026-10-03 论文 · Papers2026-10-03 · Saturday, October 3, 2026 Finding the Right Fit: Model-Harness Interactions across Agent Tasks arxiv.org原文 ↗ 评测方法基准编码 研究在三套基准上测了 66 个模型 - harness 配对,显示模型排名会随执行框架翻转。Terminal-Bench 4 中 Claude 在 OpenHands 比 GPT 高 7.94 分,却在 PI 低 30.16 分;openJiuwen 让 Kimi 在三项基准均达到自身最高,优势介于 5.61 - 11.11 分,厂商原生 harness 并非稳定最优。 –浏览 –点赞 复制链接 评论 · Comments
评论 · Comments