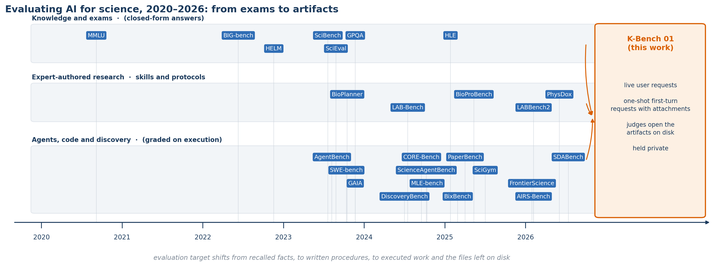
返回本期 · Back to 2026-08-26 论文 · Papers2026-08-26 · Wednesday, August 26, 2026 K-Bench: Benchmarking Agentic Coding in Live Engineering Environments arxiv.org原文 ↗ 基准执行环境与沙箱编码 K-Bench 收集带附件、信息不全且没有唯一标准答案的真实首轮工程请求,让九个前沿模型在同一沙箱完成 1602 次任务,再由三位盲评者按八维量表审阅。没有一个模型同时越过三名评委的验收线;GPT-5.6-Sol 均分最高为 8.04,但两位评委仍将 Claude Opus 5 排在首位。39934 个子项分数中 47.6% 低于 8,准确性均分 6.22 而表达为 7.33,提示当前代理更容易“交付得像完成了”而非真正完成。 –浏览 –点赞 复制链接 评论 · Comments
评论 · Comments