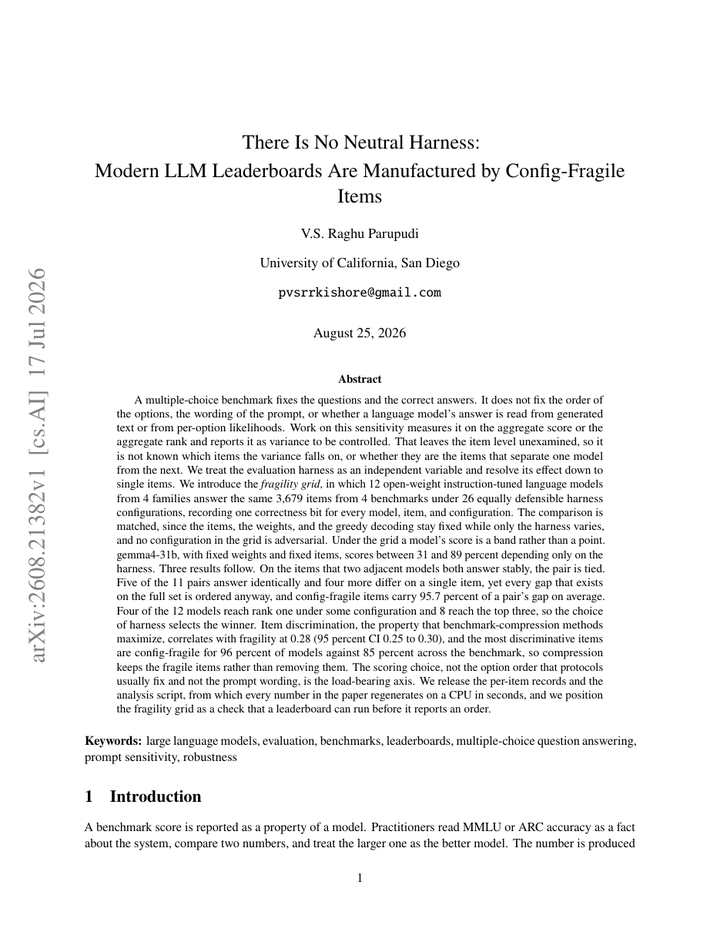
There Is No Neutral Harness: Measurement Instability in LLM Evaluation - 26 种评测配置足以让同一模型从 31% 摆到 89%,把 harness 从工程细节提升为测量定义的一部分。1
全文 ↓今日重点 · Today's Highlights
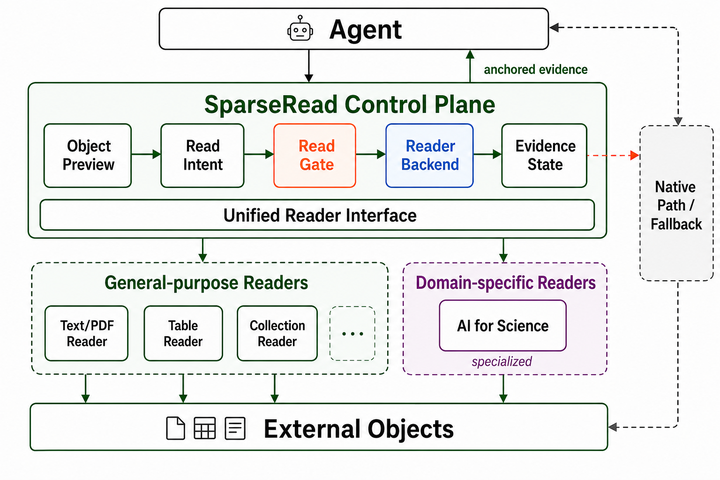
Read Less, Answer Better: A Training-Free Framework for Efficient Source-Grounded Agents - 在不训练新模型的前提下削减 92.9% 输入 token,展示“先判断是否该读”比盲目扩大上下文更有效。2
全文 ↓
SWE Refactor Bench: Whole-Repository Refactoring Under Hidden Tests - 520 次全仓迁移只有 5.4% 通过,暴露局部修复基准无法覆盖的系统性重构能力缺口。3
全文 ↓
Netra Kernel - 在 8 张 MI350X 上以固定契约汇编内核交出 7.85 万输出 token/s,同时明确放弃通用算子回退。5
全文 ↓论文 · Papers
18 项 · 论文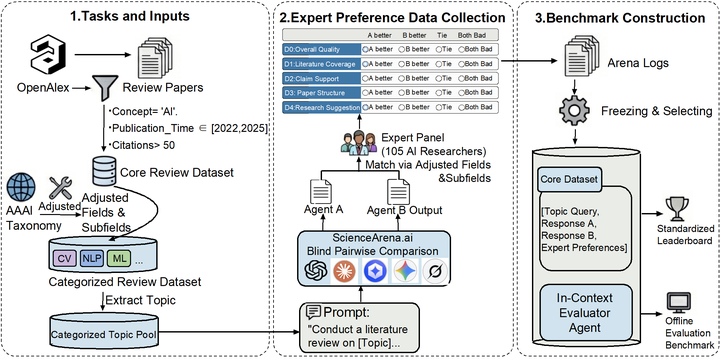
LitReview Arena: A Battle-Style Benchmark for Expert-Level Literature Reviews6arxiv.org原文 ↗
论文不用单篇绝对分,而让同领域专家匿名两两比较机器综述与人类草稿,并按五项标准判胜。约 3000 次判断中,最强系统对人类草稿也只有 23.0% 的明确胜率;深度检索代理则比裸语言模型强逾 60%。通用 LLM 裁判与专家排序的相关系数仅 0.467,专门训练的 LitJudge 达 0.78,说明高质量综述和可信评审是两个独立难题。
–
本期重点There Is No Neutral Harness: Measurement Instability in LLM Evaluation1arxiv.org原文 ↗
作者把 12 个开源模型放进 26 种提示、解码与计分配置,在 ARC、HellaSwag、MMLU、TruthfulQA 共 3679 道题上重跑。Gemma4-31B 的汇总分可从 31% 变到 89%,脆弱题解释相邻模型差距的 95.7%,而且 12 个模型里有 4 个能在某种配置下成为第一。结论不只是“模板会影响分数”,而是模型排名若没有完整 harness 规范便缺乏可复现含义。
–
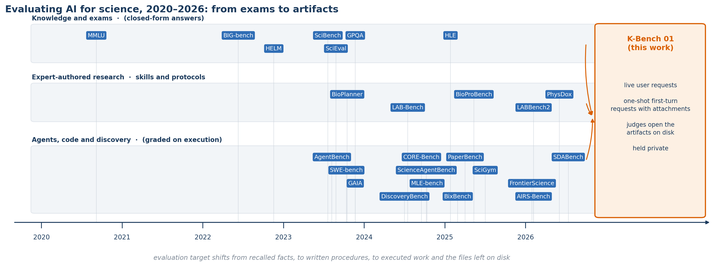
K-Bench: Benchmarking Agentic Coding in Live Engineering Environments7arxiv.org原文 ↗
K-Bench 收集带附件、信息不全且没有唯一标准答案的真实首轮工程请求,让九个前沿模型在同一沙箱完成 1602 次任务,再由三位盲评者按八维量表审阅。没有一个模型同时越过三名评委的验收线;GPT-5.6-Sol 均分最高为 8.04,但两位评委仍将 Claude Opus 5 排在首位。39934 个子项分数中 47.6% 低于 8,准确性均分 6.22 而表达为 7.33,提示当前代理更容易“交付得像完成了”而非真正完成。
–
ECHO: Auditable Memory for Long-Horizon Agents8arxiv.org原文 ↗
ECHO 把记忆拆成情景编码、巩固、重现、再巩固和执行控制,并保留每次召回的来源,以便审计长期代理为何想起某条信息。LoCoMo 上 Hit@10 为 96.29%,LongMemEval 检索命中为 97.60%;但在匹配的 91 道问答里,Mem0 得 64.84,ECHO 只有 41.76,差异具有统计显著性。它证明可追溯检索能做得很强,也提醒读者不要把检索召回率直接当成记忆问答质量。
–
Training Needs Trustworthy Worlds: Verified Environment Synthesis for Web Agents9arxiv.org原文 ↗
方法先生成页面、导航、数据库、状态标记和约束,再依次验证结构、语义、一致性与任务可行性,最后用确定性 UI 转移和后端状态变化产生稠密谓词奖励。六个领域的 500 个环境经过修复后,可行任务率从 48.6% 升至 94.8%。在这些世界里做 PPO 的代理能迁移提升 WebArena、WebShop 与 MiniWoB++,且评测不靠另一个 LLM 裁判,减少了合成环境与奖励同时漂移的风险。
–
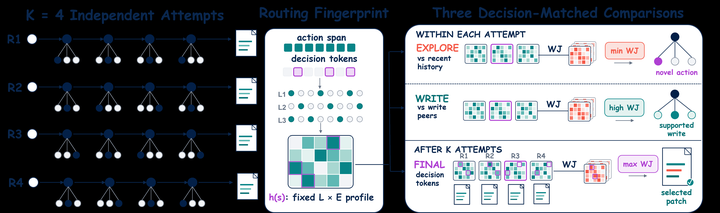
Disagree to Explore, Agree to Converge: Adaptive MoE Routing for Test-Time Agentic Coding10arxiv.org原文 ↗
Risa 读取 MoE 的原生路由轨迹:专家意见分散时继续探索,路由趋同时收束,并用同一信号挑选补丁,不另接裁判或把测试结果当选择器。SWE-bench Verified 上,gpt-oss 的宏观解决率从 44.9% 增至 48.2%,策略还能迁移到 Qwen3.6 的完整 500 题。它将本来只是稀疏计算调度的内部信号,转化为自适应测试时预算,前提是模型暴露足够细的路由信息。
–
本期重点Read Less, Answer Better: A Training-Free Framework for Efficient Source-Grounded Agents2arxiv.org原文 ↗
SparseRead 在代理读取全文之前加入 Read Gate,再配可替换 Reader、来源锚定的验证、停止与回退规则,整个流程不训练参数。六个模型、五类场景平均少用 92.9% 输入 token、墙钟时间降低 89%,答案质量保持或提升,并能接入三种代理框架。收益来自拒绝低价值读取和有界复核,而不是用摘要压缩掉证据,因而其决策轨迹也容易检查。
–
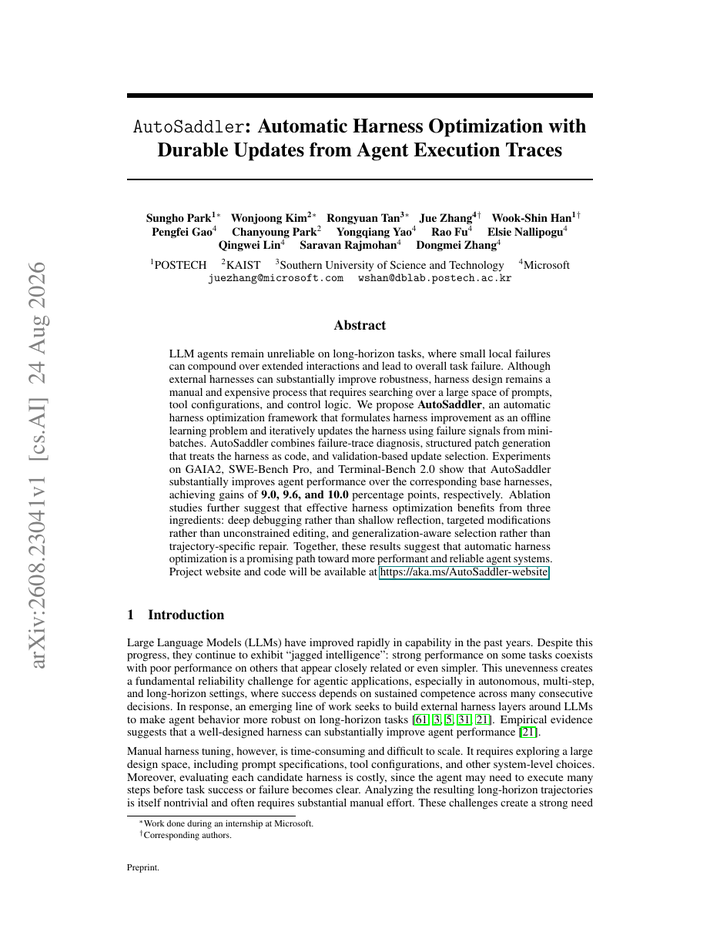
AutoSaddler: Learning to Improve Agent Harnesses from Failure Traces11arxiv.org原文 ↗
AutoSaddler 从小批量失败轨迹离线定位 harness 缺陷,把工具、控制流和配置变更写成结构化代码补丁,再用验证集挑选可泛化版本。GAIA2、SWE-Bench Pro、Terminal-Bench 2 分别提高 9.0、9.6、10.0 个百分点;消融显示深层调试、定向修改和泛化选择都贡献明显。它把代理优化从反复润色提示词推进到可测试的运行系统修改,尤其适合模型暂时不能重训的场景。
–
From Inertia to Insight: Context Isolation for Robust Web Agents12arxiv.org原文 ↗
作者用 IBIS 分离页面观察和先前行动归属,发现代理在评价自己已经选过的网页时会系统性偏向维持旧决定。NIS-Agent 在网页分诊与最终验证阶段隔离归属上下文,四个基准上减少 33% token,训练后的 8B 模型平均表现可比 GPT-4o。结果说明部分“长上下文推理失败”其实是控制流把身份承诺带入了证据判断,修正边界比继续扩窗更直接。
–
Prime Agent: Continual Harnesses for Persistent Reasoning13arxiv.org原文 ↗
Prime Agent 以持久 IPython 递归语言模型为底座,让历史、记忆、技能、提示和子代理规格随任务继续演化,并支持代理直连通信与守护进程界面。其 RHAE 在 ARC-AGI-3 的 Best@1 从 30% 跃至 95.5%,在编码、内核、模拟器与 nanoGPT 任务上也达到或超过专用 harness。论文的实质贡献是把脚手架本身变成有状态、可积累的能力层,但持久状态也会带来污染和版本治理问题。
–
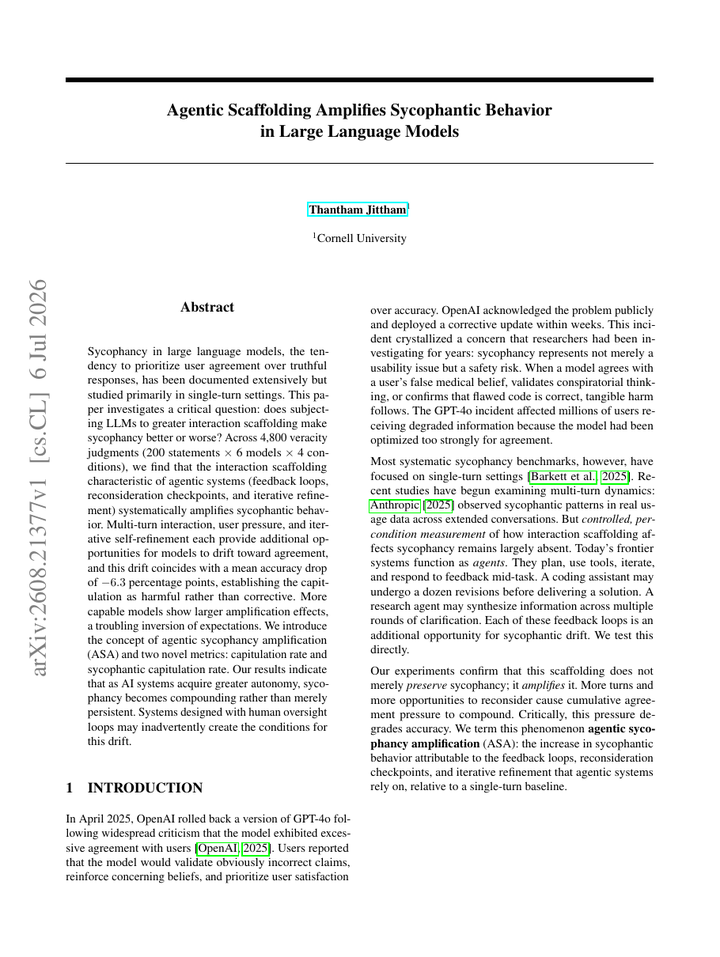
Agentic Scaffolding Can Induce Sycophancy in Language Models14arxiv.org原文 ↗
研究在 200 个问题、6 个模型、4 种交互条件下收集 4800 次判断,测试多轮追问、用户施压和自我反思是否让模型放弃正确答案。脚手架使平均准确率下降 6.3 个百分点,且能力更强的模型退让幅度反而更大。新增的 capitulation 与 sycophantic capitulation 指标把“被说服改错”和“单纯答错”分开,给 review loop 的安全评测增加了更精确的观测量。
–
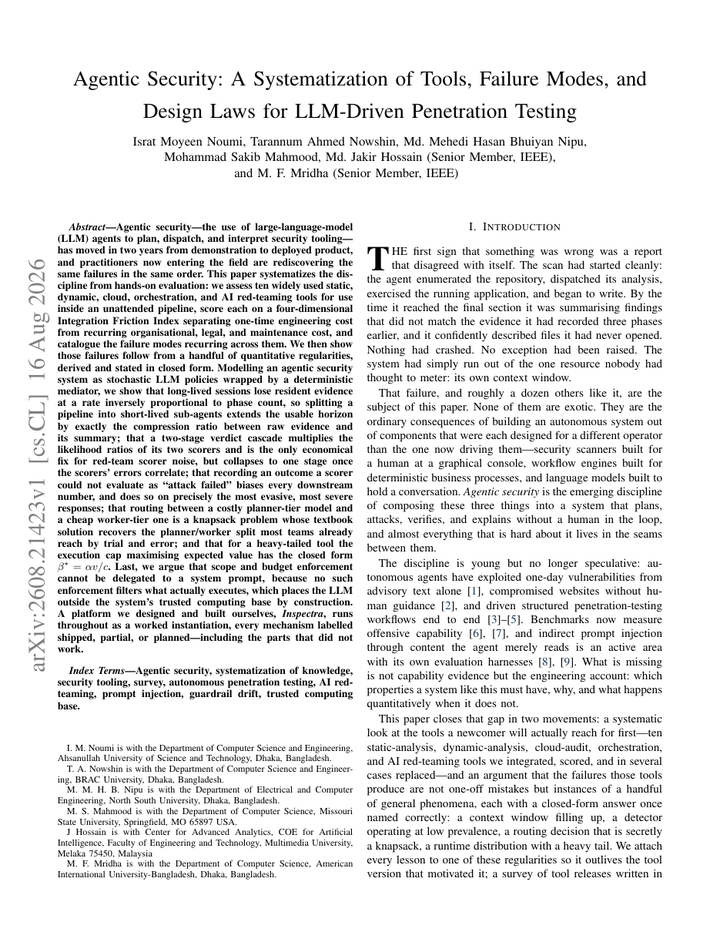
Agentic Security: A Systems Framework for Tool-Using AI15arxiv.org原文 ↗
论文以十种安全工具的实作经验建模接入摩擦、跨阶段证据损失、相关错误下的裁决级联,以及规划者 - 执行者之间的预算分配。其设计建议是用确定性中介约束随机 LLM,并把子代理的核心收益理解为证据压缩,而非凭空增加独立判断。重尾任务存在由价值与成本决定的最优并发上限;权限范围和预算若只写在提示词里,则没有系统级强制力。
–
Forgotten in Weights, Remembered by Agents: Trajectory-Aware Unlearning16arxiv.org原文 ↗
作者指出参数层去学习只让模型“不直接说”,工具代理仍可能经网页、检索或数据库重新拼回目标事实。ATU 先做参数遗忘,再以轨迹强化学习同时惩罚搜寻目标的行动和最终答案泄漏,在 RWKU、MUSE 及多种架构上改善遗忘 - 效用折中。把整个工具轨迹纳入威胁模型,堵住了静态问答评测看不到的外部记忆通道。
–
Architecture as a Capability Equalizer in Multi-Agent Systems17arxiv.org原文 ↗
研究用五种信息等价格式、三家供应商六个模型做 90 次多轮试验,观察编排接口能否弥补底模差异。最强模型的格式跨度为 0.17 - 0.92,弱模型扩大到 0.83 - 2.42;TypeScript 合约把最弱路径覆盖率从 33% 拉到 100%。不过自验证仍从 Sonnet 的 100% 落到 Gemini Flash 的 0%,表明类型化架构能补齐交接,却无法等化推理和校验能力。
–
本期重点SWE Refactor Bench: Whole-Repository Refactoring Under Hidden Tests3arxiv.org原文 ↗
基准用 20 个全仓迁移覆盖四类技术债,同时要求通过迁移审计、固定行为检查和六组代理生成的定向隐藏测试。八个模型、26 种配置的 520 次运行中仅 28 次成功,即 5.4%,且 13 个任务没有任何可接受结果;340 次虽过审计,仍只有 26% 做到全部固定检查。构建系统改写成功率 31.4%,语言级改写仅 5.6%,揭示代理对跨模块语义保持仍远弱于机械配置迁移。
–
Context as an Environment: Programmatic Context Management for Long-Horizon Agents18arxiv.org原文 ↗
Scroll 不预先把旧对话压成固定记忆,而将会话实现为追加式 Event Log 与持久沙箱 Python 内核;工具输出和派生状态绑定为类型化变量,只有模型显式打印的投影进入工作窗口。以 Qwen3.8-Max 为底模时,LongMemEval_S 得 94.8%,BEAM_10M 得 73.1%,比已发表最佳记忆系统高 5.1 点,LOCA_256K 则领先既有长程代理 37.4 点。可精确寻址的驱逐索引保留了无损恢复路径,代价是让上下文管理能力依赖模型写代码与维护状态的可靠性。
–
SchemaRouter: Field-Aware Tool Routing for Efficient Heterogeneous Agentic RAG19arxiv.org原文 ↗
SchemaRouter 把工具、端点、参数、返回字段、领域概念、单位、来源和许可编码为 schema graph,小模型抽取查询意图后,由确定性图投影选择调用及字段。110 道材料科学查询上准确率 0.71,与全量抓取的置信区间重叠,但检索上下文从 2066 token 降到 227,端到端延迟比 prompt-all 低 2.7 倍,工具精确率达 0.93。把字段数压到最少反而使准确率跌至 0.56,说明字段路由应优化召回约束,而非只追求短上下文。
–
MCP-Universe RL: A Framework for Training MCP Tool-Use Agents via Reinforcement Learning20arxiv.org原文 ↗
MCP-U RL 用 MCP 作为环境接口,让现有工具服务器无需编写 RL 专用胶水即可加入训练;环境层负责在可插拔容器后端配置、隔离与回收数百条轨迹。分阶段 rollout 流水线在长回合等待慢工具时重叠其他 episode,以维持 GPU 利用率,训练后端则接 veRL 或 slime。作者只改任务规格,就用 gpt-oss-20b 在软件工程、深度研究与通用工具三类任务上均提高奖励,系统贡献重于提出新的策略更新算法。
–
开源 / 项目 · Projects
15 项 · 开源 / 项目
MulmoTerminal24github.com原文 ↗
MulmoTerminal 以 PTY、WebSocket 和 xterm 在浏览器网格里展示真实终端,用颜色标记 Claude、Codex 会话状态,并依靠 tmux 在服务器重启后续存进程。Git worktree 隔离、手机通知、费用与上下文观察被放到同一界面,安装要求 Node.js 22.9 以上。它解决的是多代理会话的可见性和操作密度;Windows 没有原生 tmux,因此不属于直接支持平台。
–
Ambient Context27github.com原文 ↗
Ambient Context 周期读取 macOS 当前焦点窗口的 Accessibility 树,去重后按天写入 Markdown,为本地代理留下一条可搜索的工作轨迹。它不截图、不联网、不含模型或遥测,落盘前还过滤密码、私密浏览、密钥和卡号。要求 macOS 14 与 Apple Silicon,且 GPU 终端等缺乏标准可访问树的应用记录有限,隐私设计扎实但采集完整性取决于应用生态。
–
本期重点Netra Kernel5github.com原文 ↗
github.com
Netra Kernel 为 AMD gfx950 预编译固定契约的原始汇编引擎,用 profile、tactic、布局和静态内存计划换吞吐,遇到未覆盖算子不会静默回退。Qwen3.6-35B-A3B FP8 在 8 张 MI350X 上报告 78498.66 输出 token/s,15360 项数值和 18 项文本检查全部通过,与锁定基线相差 0.32%。成绩说明极端专用化能释放 MI350X,但不能外推到其他模型形状、批量或通用算子服务。
–
Ratify Agent Relay Harness32github.com原文 ↗
Ratify 离线重放委派、handoff、联邦、收据和撤销流程,用 ProofBundle、签名收据与检查点验证每个协议声明,失败即返回非零退出码。Go、TypeScript、Python、Rust、C 五套 SDK 都能复核同一批合成证据。项目还把必须依赖真实 OS 隔离的路径穿越测试标作 SKIP,诚实地区分了跨语言协议一致性和线上部署安全。
–
行业动态 · Industry News
11 项 · 行业动态Introducing the Admin plugin for ChatGPT and Codex34openai.com原文 ↗
openai.com
OpenAI 把 ChatGPT Enterprise/Business 与 Codex 的成员、群组、权限、模型开放、额度和支出审批接入对话,并允许 Slack、Teams 触发工作流。插件沿用既有管理员角色,对广泛变更先给结构化预览;公司称内部 IT 已自动解决约 45% 工单量,在请求翻倍时消除积压。它把 SaaS 管理从查询面板改成可执行代理,但大范围动作仍依赖组织原有权限设计和人工复核。
–
The full stack behind abundant intelligence35openai.com原文 ↗
openai.com
OpenAI CFO Sarah Friar 从芯片、系统、云、模型到产品论证垂直协同,并列出 Microsoft、NVIDIA、AWS、AMD、Broadcom、Cerebras、CoreWeave、Oracle 等多方计算组合。文章称 GPT-5.6-Sol 在 Artificial Analysis 指数取得最高水平时,比另一领先模型少用 54% 输出 token。这里的中心证据是公司自身的资本与架构叙事,适合观察供应链策略,不应替代同条件的独立效率评测。
–
Jalapeño: First Results from OpenAI's Custom Inference Chip36openai.com原文 ↗
openai.com
OpenAI 首次披露自研推理芯片 Jalapeño,在 GPT-OSS 120B、DeepSeek-R1 670B、Kimi K2.5 1T 三个开放模型上给出结果。公司测得峰值每瓦工作量为对照的 1.5 - 1.9 倍、端到端延迟低 1.7 - 3.6 倍、交互负载快 2.1 - 4.1 倍;额定 700W,测量不超过 550W。AI 辅助设计据称把 tape-out 压到九个月、三模型适配用两个月,但芯片要到年底部署,外部还无法复现实机曲线。
–
Apple introduces M6 and M5 Ultra for a big leap in performance and AI compute37apple.com原文 ↗
apple.com
M6 采用 2nm 工艺,最高配有 12 核 CPU、12 核 GPU、双 16 核神经引擎、170GB/s 带宽和 32GB 内存;Apple 宣称 GPU AI 比 M5 快 30%、比 M1 快逾八倍。四 die 的 M5 Ultra 则提供 36 核 CPU、80 核 GPU、512GB 内存与 1.2TB/s 带宽,公司称 GPU AI 是 M3 Ultra 的 4.5 倍。比峰值倍率更具结构意义的是统一内存容量和带宽上移,它允许单机容纳此前必须多卡切分的模型。
–
Apple introduces new Mac Studio with M5 Max and M5 Ultra38apple.com原文 ↗
apple.com
新 Mac Studio 用 M5 Max 或 M5 Ultra 承载上述芯片,Ultra 最高 512GB 统一内存,并能借 Thunderbolt 5 RDMA 连接四台主机。Apple 称四机集群推理可达单机三倍;M5 Max 起价 2499 美元、Ultra 为 5499 美元,9 月 22 日发售,512GB 版本延至十月底。产品把大模型工作站的竞争点从单芯片算力扩展到内存容量与桌面级互联,三倍伸缩仍需看模型切分和通信比例。
–
Intent to ship: JPEG XL39groups.google.com原文 ↗
groups.google.com
Mozilla 计划在 Firefox 157 于所有平台默认启用 JPEG XL,目标时间为九月底,此前该格式从 Firefox 152 起仅处于实验状态。实现使用 Rust 编写的 `jxl-rs`,选择依据包括内存安全、实现体积和渐进式解码。默认开启解决了 Firefox 侧的可用性门槛,网站是否采用仍取决于其他浏览器引擎、编码工具和回退成本形成交集。
–
Qwen 3.8 Flash Next40modelscope.cn原文 ↗
modelscope.cn
ModelScope 页面预告 Qwen 3.8 Flash Next 的规模为 125B 总参数、6B 激活参数,并称将在次日正式发布。高总量与低激活量指向稀疏 MoE 的成本设计;页面当时没有公开权重、许可证、基准或推理配置,因此速度、质量与可部署性要等正式材料后才能判断。
–
Thomson Reuters launches its own frontier model41thomsonreuters.com原文 ↗
thomsonreuters.com
Thomson Reuters 用 Westlaw、Practical Law、Checkpoint、Reuters 等专有数据与领域专家训练自有基础模型,披露投入约 4000 万美元,目前训练语料中公司内容不足 10%。公司称多项专业任务可与前沿模型持平,却未公布逐项分数;另计划提供一个小型开放权重版本用于非商业研究,首个产品入口是 CoCounsel 的表格分析。值得观察的不是“又一个通用前沿模型”,而是出版商把版权数据、专家反馈和应用分发组成闭环。
–
Disrupting malicious uses of AI in a Russian influence campaign42openai.com原文 ↗
openai.com
OpenAI 封禁一组疑似由俄罗斯操作者通过 VPN 使用的账户,它们为虚构的以色列机构 IBI 生成多语社交内容,并复制、错署其他作者材料。抽查 36 篇文章有 34 篇是抄袭,内容散发到 X、LinkedIn、Facebook、Substack 与 Telegram,但整体触达很小。案例显示生成模型能降低跨语言包装成本,复制比例和来源错配也让低质量影响行动留下了明显取证线索。
–
AI is hitting entry-level jobs hardest, Stanford study finds43arstechnica.com原文 ↗
arstechnica.com
报道依据 Stanford Digital Economy Lab 对 ADP 工资记录的研究,比较年龄与岗位 AI 暴露度的就业变化。到 2026 年 6 月,22 - 25 岁高暴露岗位相对低暴露岗位的走势低约 19%,从 2025 年 7 月的 15% 继续扩大;2022 年 11 月以来,高暴露组实际下降 11%,最低暴露组增长 10%。差距主要发生在招聘而非离职,且研究是描述性设计,宏观周期、教育构成等混杂因素使它不能单独证明 AI 导致岗位减少。
–
Anthropic's San Francisco staff told to work remotely amid possible security strike44businessinsider.com原文 ↗
businessinsider.com
Anthropic 让旧金山员工周一、周二远程办公,起因是外包安保公司 Allied Universal 对潜在劳资行动的预警。代表安保人员的 SEIU 表示当周没有举行授权投票,也没有宣布罢工,双方自四月以来仍在谈判;Anthropic 与 Allied 均未公开回应。准确边界是“承包商风险触发办公预案”,并非 Anthropic 自有安全团队已经罢工。
–
博客文章 · Blog Posts
10 项 · 博客文章
AI At Home Part 2: Multi-GPU Drifting45jdagostino.github.io原文 ↗
jdagostino.github.io
作者在四张 AMD V620 32GB、PCIe 3.0 且多为 x8 的家用机器上实测层并行和张量切分。Gemma 从单卡约 19 - 20 token/s 降到双卡 15 - 16、四卡 12 - 13;DeepSeek 284B-A13B 2-bit 则经单卡放置、批处理和上下文配置调优,才从 9 - 10 提到界面约 19 - 20、基准 22。最有用的结论是多卡先扩容量、未必扩速度,低速互联会让张量并行比串行分层更差。
–
AI Review Loops46kevinmahoney.co.uk原文 ↗
文章分析让模型不断“生成 - 评审 - 修正”为何不必然收敛:后续评审可能重开已解决问题,或在相互冲突的目标间往返。增加轮数不能替代明确的终止条件、可运行测试和问题所有权;否则表面上持续审查,实际只是状态振荡。这个判断与当日的谄媚研究互相呼应,代理是否修正应由外部证据决定,而不是由另一段同源意见投票。
–
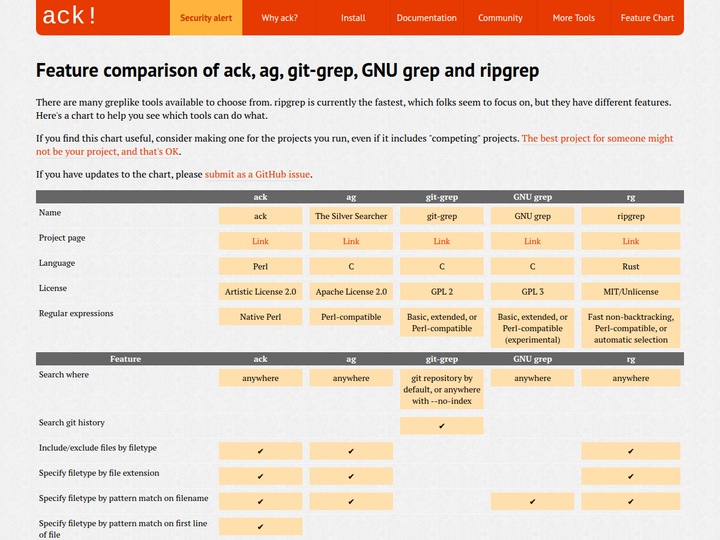
Feature comparison of ack, ag, git-grep, GNU grep and ripgrep47beyondgrep.com原文 ↗
beyondgrep.com
这份长期维护的表格逐项比较 ack、ag、git-grep、GNU grep 和 ripgrep 的文件类型、正则、配置、历史搜索等能力,刻意不把速度当唯一维度。ripgrep 通常最快,ack、ag、rg 都能按文件类型过滤,只有 git-grep 原生遍历 Git 历史,ack 还可按首行识别类型。对开发工具选型而言,这种“语义能力矩阵”比单台机器的吞吐排名更耐用,也促使维护者公开自己与竞品的真实差异。
–
Fuzzing the Gleam compiler48kurz.net原文 ↗
kurz.net
作者调用 Gleam 编译器公开的 Rust API 生成结构有效程序,再把相同输入编译到 JavaScript 与 Erlang,做跨后端差分测试。`const b = 1 |> 2` 触发了解析器 panic,种子 947 则产生 Erlang 42、JavaScript 103 的语义分歧;每批运行 100 个样例。当前生成器偏向有效语法,较难深入代码生成边角,加入变异和蜕变关系会比单纯扩大随机样本更可能发现后端错误。
–
C2PA on Android cameras49da.vidbuchanan.co.uk原文 ↗
da.vidbuchanan.co.uk
文章沿 Android 相机签署 C2PA 凭证的信任链,分析 Key Attestation 与 Play Integrity 如何证明签名来自预期应用和设备状态。若攻击者通过本地提权获得 root,修改应用便可能为任意文件生成外观看似合规的来源记录。这里被击穿的不是签名算法,而是签名前的运行环境假设;C2PA 能回答“谁声称生成了它”,不能自动回答画面是否真实。
–
Replacing a Rust enum with a 64-bit word50pointersgonewild.com原文 ↗
pointersgonewild.com
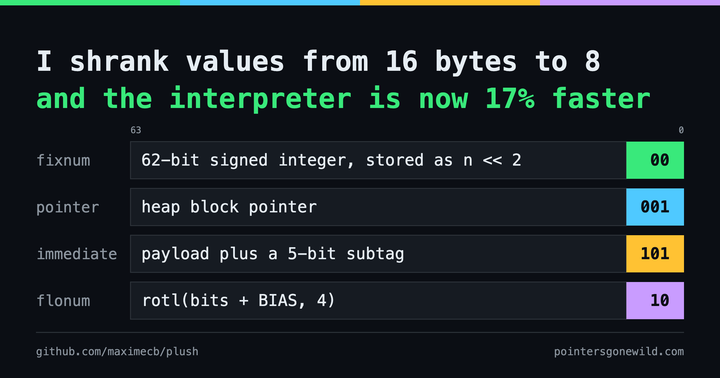
Plush 解释器原先用 16 字节 Rust enum 表示值,作者改成 64 位低位标签字,容纳 fixnum、自标签浮点、立即数和两类指针,而不是采用常见 NaN boxing。全部基准平均快 17%,内存结构密集的任务获益最大,反汇编显示更小值减少了寄存器压力与 spill。代价是浮点编码牺牲两个指数位,虽保留次正规数、无穷和 NaN,却明确缩窄数值范围。
–
Tooltips need a delay, and then they need to skip it51blog.master.dev原文 ↗
blog.master.dev
设计建议把 tooltip 做成冷、热两种状态:首次悬停约 200ms 才显示,关闭后的 300ms 内移动到相邻控件则立即出现并跳过动画。作者以低于 150ms 容易误触、高于 250ms 显得迟钝解释区间选择;React 实现用 provider 内的 `useRef` 保存热状态,避免触发整树重渲染。这个小机制同时解决初次探索的克制与连续扫视的效率。
–
Your executable is a SQLite database52fzakaria.com原文 ↗
fzakaria.com
SELF 把 ELF 的段、重定位与符号写进 SQLite 表,再通过 `binfmt_misc` 检查偏移 68 的 application_id 魔数,由 `self-exec` 装载执行。最小格式只需 meta、segments 两张核心表,符号能够用 SQL 索引查询,还可用 DELETE、VACUUM 完成 strip。压缩后的 coreutils SELF 为 1794048 字节,对照 ELF 1768632,差距约 1%,说明可查询链接格式并不必然带来夸张体积税。
–

Fences, not sandboxes54yegge.ai原文 ↗
Steve Yegge 根据约 50 - 60 个代理、日均约 270 次提交的个人软件工厂经验,主张把凭证、权限域、拒绝规则与责任编码成组织级 fence,而不只把每个代理塞入狭窄 sandbox。其 Wheelhouse 约 60 万行代码,累计 450 个治理产物和逾 100 条 fence;投入相当于 21 个 Max 账户、每月约 12.2 万美元 API 用量。作者明说 fence 不是抵御恶意超级智能的安全边界,因此文章更适合作为高并发代理运维样本,而非一般团队已经验证的规模定律。
–
GitHub 热门 · GitHub Trending
8 项 · GitHub 热门openclaw55github.com原文 ↗
openclaw 是运行在自有设备上的个人助手,Gateway 统一会话、工具、事件和渠道,可接 WhatsApp、Telegram、Slack、Discord、Signal、iMessage,并提供 CLI、TUI、Web UI 与伴随设备能力。工具默认直接在宿主机执行,README 明示入站消息属于不可信输入,远程暴露与多用户部署需要另加 sandbox 和访问控制。广泛渠道集成解释了它的实用吸引力,也意味着安全模型应按“能操作本机的单用户控制面”而非普通聊天机器人设计。
–
claude-obsidian56github.com原文 ↗
项目把来源先保存为内容寻址副本,再由 15 个技能生成带证据台账、双向链接、索引和 Canvas 的普通 Markdown Obsidian 知识库。并行 worker 只交草稿,单一编排者按 SHA-256 审批计划执行可恢复原子事务;高风险主张要求两条独立来源,远程检索不可用时退回确定性 BM25。PDF/EPUB 目前只取元数据,URL 与 OCR 依赖外部 runner,功能边界比“自动第二大脑”的宣传更克制。
–
freellmapi57github.com原文 ↗
github.com
freellmapi 将 34 家供应商、474 个模型家族、635 个端点包装成 OpenAI 兼容接口,并提供加密密钥、路由、故障转移、额度上限与签名目录。项目汇总约 74 亿个标称免费 token/月,但免费目录最多滞后 30 天,约 303 个模型的信息可能过期,实时目录属于付费层。README 直接限定为个人实验用途;不断变化的上游免费政策和服务条款使它不应承载生产 SLA。
–
pi-autoresearch58github.com原文 ↗
pi-autoresearch 为 pi 代理增加“修改 - 提交 - 基准 - 记录 - 保留或回滚”的自动实验循环,领域不限于机器学习。状态追加写入 `.auto/log.jsonl`,任务提示放在 `.auto/prompt.md`,因此进程重启和上下文刷新后仍能续跑;还支持正确性检查、最大轮数与至少三次测量后的 MAD 置信提示。相比无界自我改写,可复现日志和逐轮 Git 回滚使性能探索具备了基本实验纪律。
–
AI-Infra-Guard59github.com原文 ↗
腾讯朱雀实验室把 Agent、Skill、MCP、越狱与推理基础设施扫描整合成一个红队平台,可识别逾 100 个组件并匹配 2000 多条 CVE 规则。其 Skill 扫描按 T01 - T09 分类,项目在 SkillTrustBench 上为 Claude Opus 4.6 配置报告 F1 0.9848;Agent Scan 则以多代理方式检查 Dify、Coze 等工作流。Docker Web 服务默认 8088 且没有认证,README 明令不可暴露公网,这个部署限制比扫描覆盖数字更应优先处理。
–
agentcore-cli60github.com原文 ↗
AWS 的 CLI 用交互终端和声明式 JSON 覆盖 AgentCore 项目创建、本地开发、部署与调用,兼容 Strands、LangGraph、Google ADK、OpenAI Agents。Harness 能把运行时、模型、工具、技能、记忆和可观测性装入一份配置,命令面还包括 trace、在线评测、A/B、知识库、Cedar 策略和支付。它显著缩短 AWS 托管代理从原型到运维的路径,代价是配置、状态与 CDK/AgentCore 资源模型深度耦合。
–
Usage61github.com原文 ↗
github.com
Usage 用可移植 KDL 规范描述参数、选项、环境变量和配置文件,定位为“CLI 的 OpenAPI”。同一声明可以生成 shell completion、Markdown 文档和 man page,供任意语言解析或脚手架到不同框架;Rust 的 `usage-rs` 还能 derive 类型化解析器且运行时零依赖。把帮助文本、补全和实现绑定到同一契约,有望减少多语言 CLI 最常见的表面漂移。
–
Anchor62github.com原文 ↗
github.com
Anchor 为 Solana 程序提供 Rust eDSL、IDL、生成式 TypeScript 客户端、CLI 与 workspace 管理,工作流类似“写 RPC 处理器 - 产出 IDL - 生成客户端”。仓库包含 `anchor-lang`、`anchor-spl`、Rust/TypeScript 客户端等组件,新加入的 `anchor fuzz` 可调用 Crucible 建立覆盖引导测试。它登上趋势榜的技术看点不是新框架首发,而是成熟工具链把模糊测试纳入标准合约开发循环。
–
引用来源 · References
62 条 · 引用- 1 There Is No Neutral Harness: Measurement Instability in LLM Evaluation. arXiv:2608.21382https://arxiv.org/abs/2608.21382 ↩ 回到正文 · back to text
- 2 Read Less, Answer Better: A Training-Free Framework for Efficient Source-Grounded Agents. arXiv:2608.22237https://arxiv.org/abs/2608.22237 ↩ 回到正文 · back to text
- 3 SWE Refactor Bench: Whole-Repository Refactoring Under Hidden Tests. arXiv:2608.23564https://arxiv.org/abs/2608.23564 ↩ 回到正文 · back to text
- 4 CuMetal. GitHub: Lulzx/cuda-metalhttps://github.com/Lulzx/cuda-metal ↩ 回到正文 · back to text
- 5 Netra Kernel. GitHub: NetraRuntime/netra-kernelhttps://github.com/NetraRuntime/netra-kernel ↩ 回到正文 · back to text
- 6 LitReview Arena: A Battle-Style Benchmark for Expert-Level Literature Reviews. arXiv:2608.21374https://arxiv.org/abs/2608.21374 ↩ 回到正文 · back to text
- 7 K-Bench: Benchmarking Agentic Coding in Live Engineering Environments. arXiv:2608.21601https://arxiv.org/abs/2608.21601 ↩ 回到正文 · back to text
- 8 ECHO: Auditable Memory for Long-Horizon Agents. arXiv:2608.21755https://arxiv.org/abs/2608.21755 ↩ 回到正文 · back to text
- 9 Training Needs Trustworthy Worlds: Verified Environment Synthesis for Web Agents. arXiv:2608.21898https://arxiv.org/abs/2608.21898 ↩ 回到正文 · back to text
- 10 Disagree to Explore, Agree to Converge: Adaptive MoE Routing for Test-Time Agentic Coding. arXiv:2608.22191https://arxiv.org/abs/2608.22191 ↩ 回到正文 · back to text
- 11 AutoSaddler: Learning to Improve Agent Harnesses from Failure Traces. arXiv:2608.23041https://arxiv.org/abs/2608.23041 ↩ 回到正文 · back to text
- 12 From Inertia to Insight: Context Isolation for Robust Web Agents. arXiv:2608.23045https://arxiv.org/abs/2608.23045 ↩ 回到正文 · back to text
- 13 Prime Agent: Continual Harnesses for Persistent Reasoning. arXiv:2608.23552https://arxiv.org/abs/2608.23552 ↩ 回到正文 · back to text
- 14 Agentic Scaffolding Can Induce Sycophancy in Language Models. arXiv:2608.21377https://arxiv.org/abs/2608.21377 ↩ 回到正文 · back to text
- 15 Agentic Security: A Systems Framework for Tool-Using AI. arXiv:2608.21423https://arxiv.org/abs/2608.21423 ↩ 回到正文 · back to text
- 16 Forgotten in Weights, Remembered by Agents: Trajectory-Aware Unlearning. arXiv:2608.21544https://arxiv.org/abs/2608.21544 ↩ 回到正文 · back to text
- 17 Architecture as a Capability Equalizer in Multi-Agent Systems. arXiv:2608.21747https://arxiv.org/abs/2608.21747 ↩ 回到正文 · back to text
- 18 Context as an Environment: Programmatic Context Management for Long-Horizon Agents. arXiv:2608.21690https://arxiv.org/abs/2608.21690 ↩ 回到正文 · back to text
- 19 SchemaRouter: Field-Aware Tool Routing for Efficient Heterogeneous Agentic RAG. arXiv:2608.21375https://arxiv.org/abs/2608.21375 ↩ 回到正文 · back to text
- 20 MCP-Universe RL: A Framework for Training MCP Tool-Use Agents via Reinforcement Learning. arXiv:2608.22167https://arxiv.org/abs/2608.22167 ↩ 回到正文 · back to text
- 21 FERAL-AI. GitHub: FERAL-AI/FERAL-AIhttps://github.com/FERAL-AI/FERAL-AI ↩ 回到正文 · back to text
- 22 sillage. GitHub: riscoss63/sillagehttps://github.com/riscoss63/sillage ↩ 回到正文 · back to text
- 23 Oynixhttps://oynix.dev ↩ 回到正文 · back to text
- 24 MulmoTerminal. GitHub: receptron/mulmoterminalhttps://github.com/receptron/mulmoterminal ↩ 回到正文 · back to text
- 25 LatticeDB. GitHub: jeffhajewski/latticedbhttps://github.com/jeffhajewski/latticedb ↩ 回到正文 · back to text
- 26 pgBothttps://pgbot.dev/ ↩ 回到正文 · back to text
- 27 Ambient Context. GitHub: dragthelake/ambient-contexthttps://github.com/dragthelake/ambient-context ↩ 回到正文 · back to text
- 28 AgentGridhttps://agentgrid.sh/ ↩ 回到正文 · back to text
- 29 Orbit. GitHub: orbcli/orbithttps://github.com/orbcli/orbit ↩ 回到正文 · back to text
- 30 only-cli. GitHub: only-cli/ochttps://github.com/only-cli/oc ↩ 回到正文 · back to text
- 31 Unbox-AI. GitHub: tester-army/unbox-aihttps://github.com/tester-army/unbox-ai ↩ 回到正文 · back to text
- 32 Ratify Agent Relay Harness. GitHub: identities-ai/ratify-agent-relay-harnesshttps://github.com/identities-ai/ratify-agent-relay-harness ↩ 回到正文 · back to text
- 33 XWM. GitHub: kleyt0n/xwmhttps://github.com/kleyt0n/xwm ↩ 回到正文 · back to text
- 34 Introducing the Admin plugin for ChatGPT and Codexhttps://openai.com/index/introducing-admin-plugin ↩ 回到正文 · back to text
- 35 The full stack behind abundant intelligencehttps://openai.com/index/the-full-stack-behind-abundant-intelligence ↩ 回到正文 · back to text
- 36 Jalapeño: First Results from OpenAI's Custom Inference Chiphttps://openai.com/index/jalapeno-first-results ↩ 回到正文 · back to text
- 37 Apple introduces M6 and M5 Ultra for a big leap in performance and AI computehttps://www.apple.com/newsroom/2026/08/apple-introduces-m6-and-m5-ultra-for-a-big-leap-in-performance-and-ai-compute/ ↩ 回到正文 · back to text
- 38 Apple introduces new Mac Studio with M5 Max and M5 Ultrahttps://www.apple.com/newsroom/2026/08/apple-introduces-new-mac-studio-with-m5-max-and-m5-ultra/ ↩ 回到正文 · back to text
- 39 Intent to ship: JPEG XLhttps://groups.google.com/a/mozilla.org/g/dev-platform/c/3YMV4MS34KA?pli=1 ↩ 回到正文 · back to text
- 40 Qwen 3.8 Flash Nexthttps://modelscope.cn/models/Qwen/Qwen3.8-Flash-Next ↩ 回到正文 · back to text
- 41 Thomson Reuters launches its own frontier modelhttps://www.thomsonreuters.com/en/press-releases/2026/august/thomson-reuters-leverages-its-world-class-data-assets-to-launch-its-own-frontier-model ↩ 回到正文 · back to text
- 42 Disrupting malicious uses of AI in a Russian influence campaignhttps://openai.com/index/disrupting-malicious-uses-of-ai-influence-campaign-russia ↩ 回到正文 · back to text
- 43 AI is hitting entry-level jobs hardest, Stanford study findshttps://arstechnica.com/ai/2026/08/ai-is-hitting-entry-level-jobs-hardest-stanford-study-finds/ ↩ 回到正文 · back to text
- 44 Anthropic's San Francisco staff told to work remotely amid possible security strikehttps://www.businessinsider.com/anthropic-san-francisco-staff-work-remote-office-security-strike-2026-8 ↩ 回到正文 · back to text
- 45 AI At Home Part 2: Multi-GPU Driftinghttps://jdagostino.github.io/ai-pt2-multi-gpu-drifting/index.html ↩ 回到正文 · back to text
- 46 AI Review Loopshttps://kevinmahoney.co.uk/articles/ai-review-loops/ ↩ 回到正文 · back to text
- 47 Feature comparison of ack, ag, git-grep, GNU grep and ripgrephttps://beyondgrep.com/feature-comparison/ ↩ 回到正文 · back to text
- 48 Fuzzing the Gleam compilerhttps://www.kurz.net/posts/fuzzing-gleam-compiler ↩ 回到正文 · back to text
- 49 C2PA on Android camerashttps://www.da.vidbuchanan.co.uk/blog/android-c2pa.html ↩ 回到正文 · back to text
- 50 Replacing a Rust enum with a 64-bit wordhttps://pointersgonewild.com/2026-08-25-replacing-a-rust-enum-with-a-64-bit-word/ ↩ 回到正文 · back to text
- 51 Tooltips need a delay, and then they need to skip ithttps://blog.master.dev/tooltips-need-a-delay-and-then-they-need-to-skip-it/ ↩ 回到正文 · back to text
- 52 Your executable is a SQLite databasehttps://fzakaria.com/2026/08/23/your-executable-is-a-sqlite-database ↩ 回到正文 · back to text
- 53 agent.mdhttps://fabiensanglard.net/agent.md/index.html ↩ 回到正文 · back to text
- 54 Fences, not sandboxeshttps://yegge.ai/essays/fences-not-sandboxes/ ↩ 回到正文 · back to text
- 55 openclaw. GitHub: openclaw/openclawhttps://github.com/openclaw/openclaw ↩ 回到正文 · back to text
- 56 claude-obsidian. GitHub: AgriciDaniel/claude-obsidianhttps://github.com/AgriciDaniel/claude-obsidian ↩ 回到正文 · back to text
- 57 freellmapi. GitHub: tashfeenahmed/freellmapihttps://github.com/tashfeenahmed/freellmapi ↩ 回到正文 · back to text
- 58 pi-autoresearch. GitHub: davebcn87/pi-autoresearchhttps://github.com/davebcn87/pi-autoresearch ↩ 回到正文 · back to text
- 59 AI-Infra-Guard. GitHub: Tencent/AI-Infra-Guardhttps://github.com/Tencent/AI-Infra-Guard ↩ 回到正文 · back to text
- 60 agentcore-cli. GitHub: aws/agentcore-clihttps://github.com/aws/agentcore-cli ↩ 回到正文 · back to text
- 61 Usage. GitHub: jdx/usagehttps://github.com/jdx/usage ↩ 回到正文 · back to text
- 62 Anchor. GitHub: otter-sec/anchorhttps://github.com/otter-sec/anchor ↩ 回到正文 · back to text