LitReview Arena: A Battle-Style Benchmark for Expert-Level Literature Reviews
arxiv.org原文 ↗
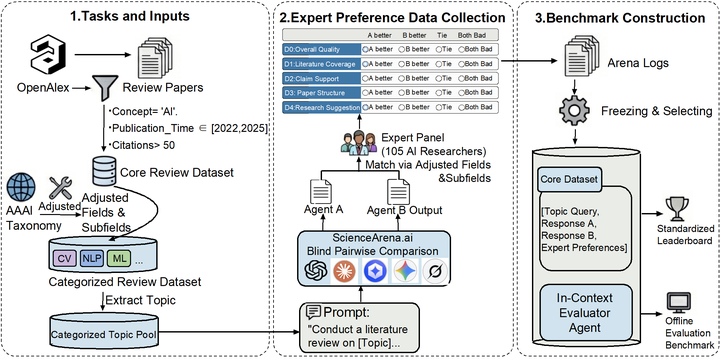
论文不用单篇绝对分,而让同领域专家匿名两两比较机器综述与人类草稿,并按五项标准判胜。约 3000 次判断中,最强系统对人类草稿也只有 23.0% 的明确胜率;深度检索代理则比裸语言模型强逾 60%。通用 LLM 裁判与专家排序的相关系数仅 0.467,专门训练的 LitJudge 达 0.78,说明高质量综述和可信评审是两个独立难题。
–浏览
评论 · Comments