What Do We Expect from LLMs? Mapping the Design of LLM Benchmarks
arxiv.org原文 ↗
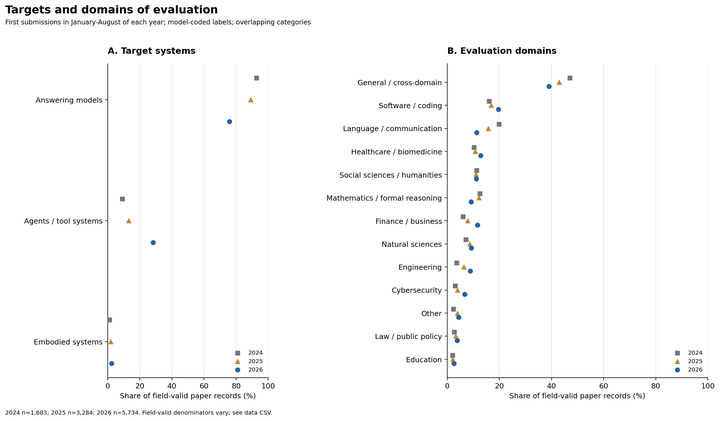
这项元研究对 2022 年 1 月至 2026 年 8 月的 14,767 篇基准论文做自动全文编码,观察“被测能力”如何变化。行动、交互和职业应用的比重上升,而模型作为评分器在代理与非代理基准中同步扩张;模型生成测试材料却没有同样的持续增幅。它把基准设计本身当作能力预期的可观测代理,也提醒模型参与出题和判分会引入自我复制的偏好。
–浏览
评论 · Comments