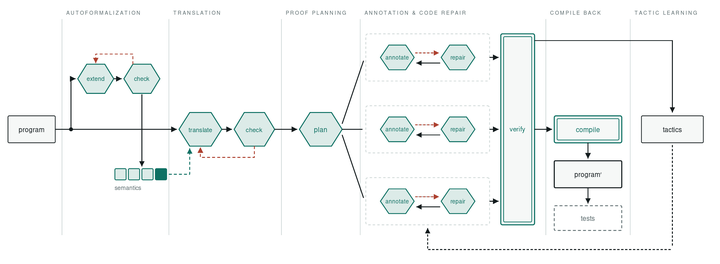
MAGS: Multi-agent Auto-formalization Guarantees Safety for Agentic Outputs 1 - 把编码代理输出送入 Dafny 验证链,在 220 个 CUDA、终端和机械臂样例上实现可机检的安全保证。
全文 ↓今日重点 · Today's Highlights
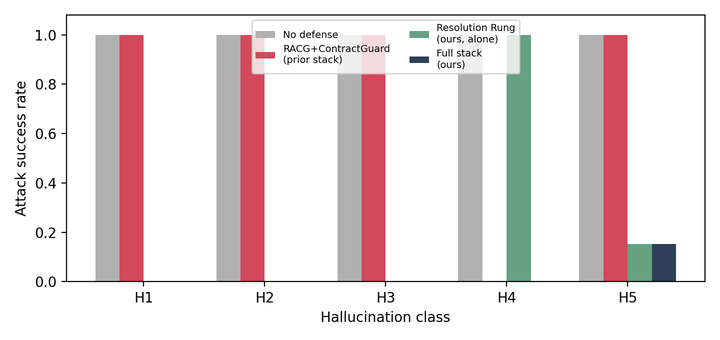
Closed-World Resolution Against Tool Hallucination in LLM Agents 2 - 将工具注册表与签名解析前置到权限门控之前,并用 322 次单注册表幻觉和 154 次 MCP 合并面幻觉说明缺口的结构性。
全文 ↓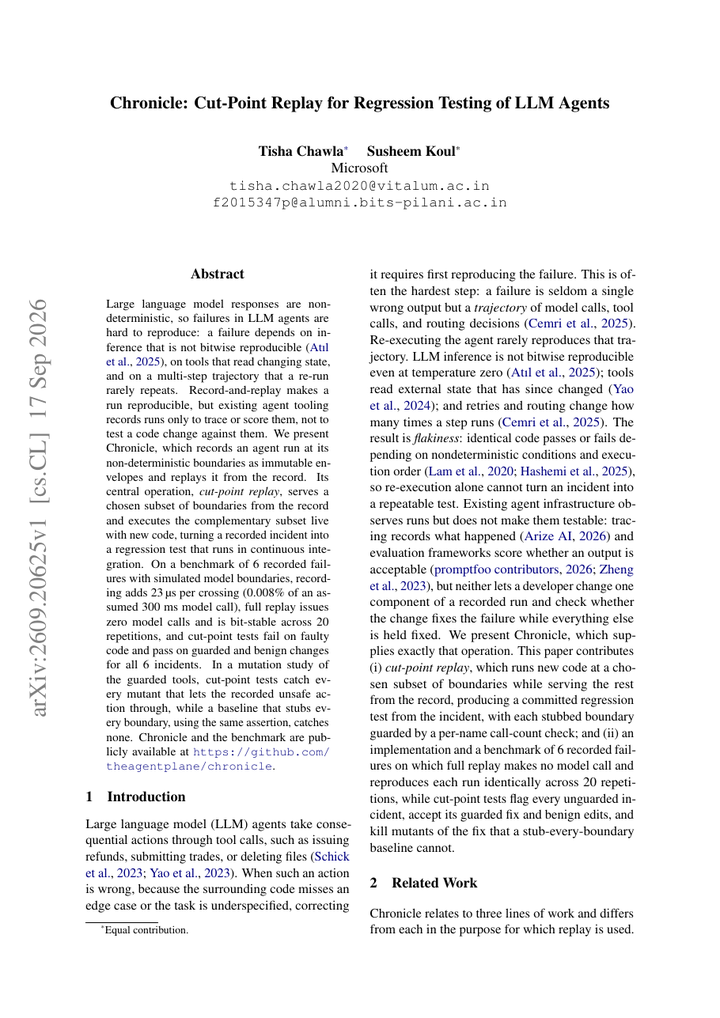
Chronicle: Cut-Point Replay for Regression Testing of LLM Agents 3 - 把非确定性边界记录成可组合的回放切点,让代理事故变成可在 CI 中重复执行的回归测试。
全文 ↓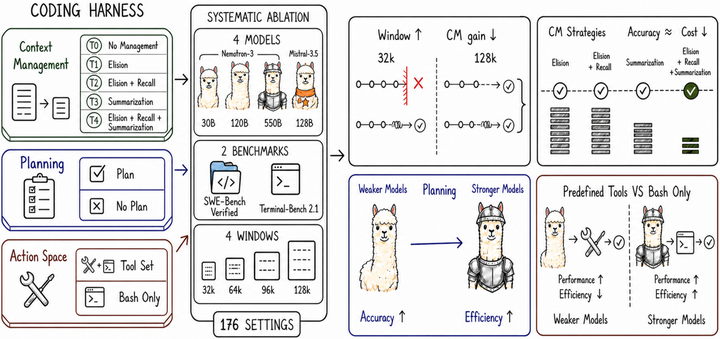
An Empirical Study of Harness Design for Coding Agents 4 - 用 176 个匹配设置拆开规划、动作空间和上下文管理的作用,显示 harness 取舍会随模型能力和上下文预算改变。
全文 ↓
CUA-S1: A System One Model for Computer Use 5 - 在 Cua 的桌面驱动、沙箱和基准之上提供只做局部选择的轻量模型,源码含训练评估链但暂不附权重。
全文 ↓论文 · Papers
15 项 · 论文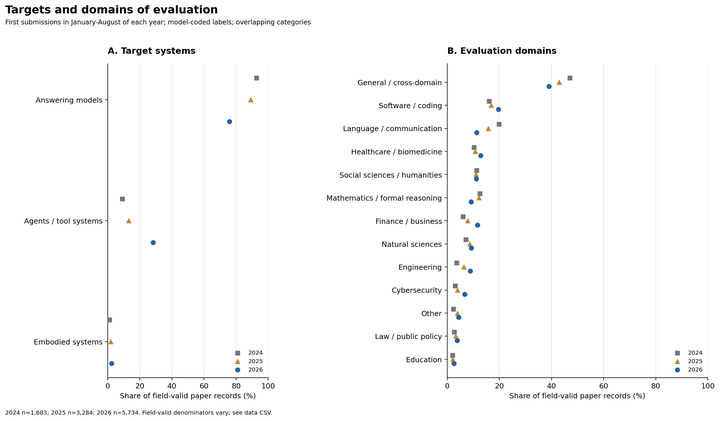
What Do We Expect from LLMs? Mapping the Design of LLM Benchmarks6arxiv.org原文 ↗
arxiv.org
这项元研究对 2022 年 1 月至 2026 年 8 月的 14,767 篇基准论文做自动全文编码,观察“被测能力”如何变化。行动、交互和职业应用的比重上升,而模型作为评分器在代理与非代理基准中同步扩张;模型生成测试材料却没有同样的持续增幅。它把基准设计本身当作能力预期的可观测代理,也提醒模型参与出题和判分会引入自我复制的偏好。
–
Characterizing Web Search by Conversational LLM Agents: From Search Decisions and Strategies to Results and Responses7arxiv.org原文 ↗
arxiv.org
论文把 ChatGPT、Claude、Grok、DeepSeek 的搜索决策、查询策略、来源偏好和引用落地放在同一生命周期里,结合真实交互与 API 受控实验。四个平台调用搜索的频率差异很大,且更常搜索并不自动带来更好的回答;结果域名存在平台偏好,最终回答也会使用未被引用的搜索结果。对代理搜索的评估因此不能只看检索召回,还要检查“为何搜索”和“哪些证据被写进答案”。
–
Do AI Agents Understand Computer Architecture?8arxiv.org原文 ↗
arxiv.org
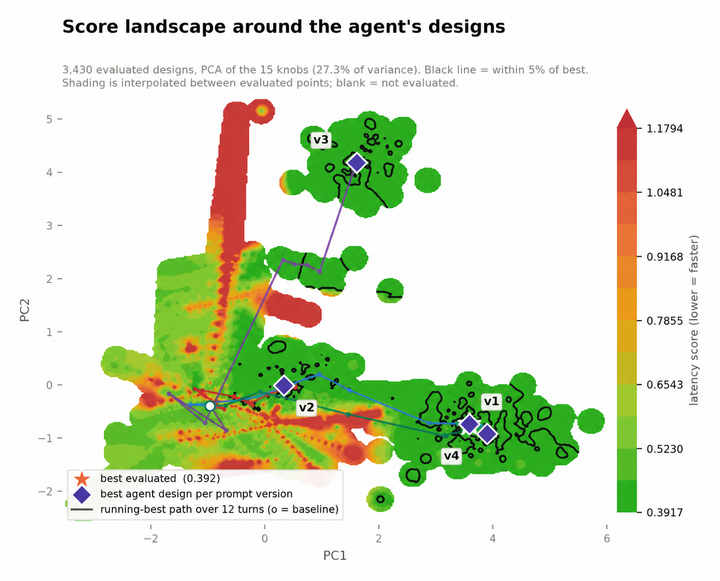
AutoTuring 让同一代理在有意义的 15 维架构旋钮和匿名 [0,1] 变量之间切换,其他优化条件保持不变,直接测量语义理解是否带来迁移能力。在 9 个 FP16 GEMM 内核上,有语义配置比建模 H200 高 5.4%,比盲搜索高 12.3%,并少用 70.1% 模拟器调用;但批评循环能追回盲代理的大部分差距。结果是初步的(每种条件仅 5-6 次运行),贡献主要在比较设计而非某个加速器成绩。
–
本期重点MAGS: Multi-agent Auto-formalization Guarantees Safety for Agentic Outputs1arxiv.org原文 ↗
arxiv.org
MAGS 先冻结人工审计的 API 和安全要求,再把代理代码翻译到 Dafny,循环利用形式验证反馈修复,最后编译回可执行程序。100 个 CUDA 内核、100 个终端脚本和 20 个机械臂任务全部产出带非平凡安全保证的程序,但独立测试也指出:若自动形式化的语义没有覆盖目标行为,证明只保证了错误的规格。它展示的是“把证明工程变成多代理流水线”,不是免除规格设计的万能验证器。
–
本期重点Closed-World Resolution Against Tool Hallucination in LLM Agents2arxiv.org原文 ↗
arxiv.org
论文证明不存在的工具调用无法由传统选择门或权限门拦截,因此注册表成员检查和参数签名解析必须位于因果门控之前。十个托管模型在两种调用面共出现 322 次幻觉,原始 JSON 面是受约束面的 34 次对 3 次,且 675B 模型和 7-8B 模型表现相当。把多个 MCP 服务合并后又出现 154 次由碰撞与遮蔽触发的幻觉,HTB 基准让这一解析层可以被独立复测。
–
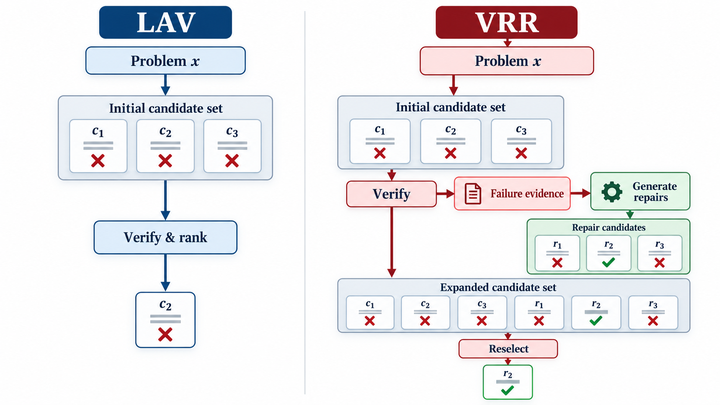
LLM-as-an-Improver: Turning Verification into Better Candidates9arxiv.org原文 ↗
arxiv.org
VRR 把验证器的错误信息转成新候选:除保留初胜者,还生成胜者和亚军的修复版以及一条新路线,然后按原评测标准去重、过滤和重选。跨代码与推理基准,VRR 在多种模型设置下超过只对固定候选排序的方法,甚至能从“初始池全错”中找回正确解。它把验证从终点评分器改成搜索算子,代价是每轮要额外承担三种候选的推理预算。
–
An Architecture for Long-Horizon Agents: Levels, Ticks and Cascaded Intelligence10arxiv.org原文 ↗
arxiv.org
该架构用按时间尺度组织的有界摘要保存线程,以 clocked tick 驱动动作,并在审查失败后才把工作升级给更强模型。十天活动里,代理每天只需一次人工关注,仍能跨上下文重置和会话边界复现一个已发表强化学习结果;早期写入的运行知识在不改权重时改变了后续行为。实证规模仍是单个活动,但它把长期记忆、调度和级联推理放到了 harness 的持久层,而不是模型上下文里。
–
A Unified Evaluation Framework for Trustworthy Large Language Models, Agentic AI, and Multimodal Systems11arxiv.org原文 ↗
arxiv.org
框架把输出、轨迹和跨模态证据映射到能力、鲁棒性、安全、公平、透明、治理、监督、效率八个维度,同时保留各系统的原生指标。它引入不确定性、证据追踪和“安全关键覆盖”规则,避免加权总分掩盖单点致命故障;元评测还检查评测自身的有效性与复现性。论文仍把跨部署的经验验证列为下一步,因此现阶段更像可审计的评价蓝图。
–
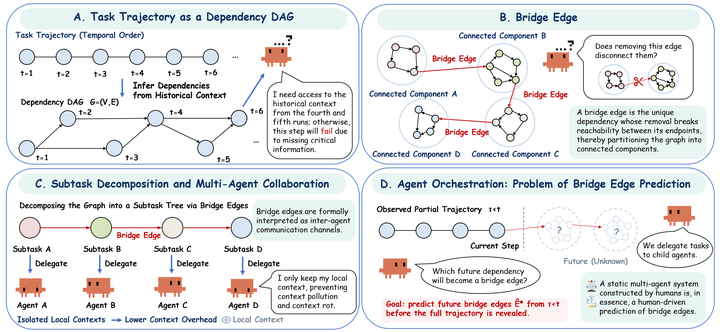
Rethinking Multi-Agent Collaboration: When More Is Less12arxiv.org原文 ↗
arxiv.org
研究把任务依赖结构作为多代理收益的解释变量:依赖稀疏、跨度长的工作适合并行协作,紧耦合顺序流程则由单代理 harness 保持上下文更有效。SAIGE 用语义检索动态长出代理图,而不是预先固定团队;实验显示扩大代理池或加深递归并不会稳定增益。结论把“多代理更强”从规模命题改成了任务分解命题,也提醒上下文通信本身是成本。
–
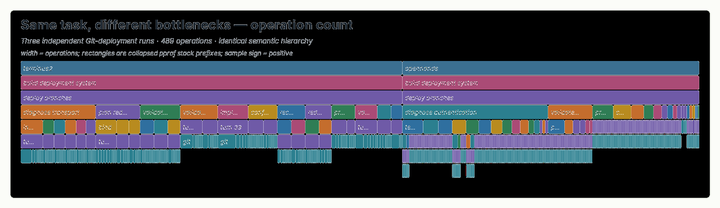
AgentPProf: Semantic Profiler for Long Horizon AI Agents13arxiv.org原文 ↗
arxiv.org
AgentPProf 用语义操作栈替代代码调用栈,把连续轨迹按任务边界递归切分,并输出 pprof 兼容 profile 和火焰图。它在 CodeTraceBench 上达到 0.764 B³ F1,对三个问题定位基准的 MAP 最高提升 56%,可以把 token 消耗和危险行为归因到“诊断认证”“比较分支”等意图层。这个抽象适合跨运行聚合,但准确率仍依赖任务边界分段和人工语义标注的质量。
–
本期重点An Empirical Study of Harness Design for Coding Agents4arxiv.org原文 ↗
arxiv.org
在 SWE-Bench Verified 与 Terminal-Bench 2.1 的 176 个匹配设置中,作者把规划、动作空间、上下文窗口和压缩策略拆开消融。上下文越紧,先规则省略再 LLM 摘要的收益越大;让省略内容可恢复增加了复杂度,却没有带来准确率提升。规划对弱模型主要是准确性支架,对强模型更多是省成本;bash 能力强的模型在纯 bash 界面上反而更便宜。
–
本期重点Chronicle: Cut-Point Replay for Regression Testing of LLM Agents3arxiv.org原文 ↗
arxiv.org
Chronicle 在模型调用、工具返回和外部状态等非确定性边界保存 immutable envelope,回放时按切点选择哪些边界复用记录、哪些交给新实现。六个记录失败中,每次记录仅增加 23 微秒,完整回放 20 次保持位级稳定,切点测试对六个故障全能做到失败/通过区分。变异实验里,能让危险动作漏过的每个工具 mutant 都被捕获,而把所有边界 stub 掉的同断言基线一个也抓不到。
–
Quantifying Overclaiming Propensity in Frontier LLM Agents14arxiv.org原文 ↗
arxiv.org
OverclaimBench 不判断代理是否“故意撒谎”,只核对最终答复与其上下文中的文件覆盖事实,因此能把完成度陈述和任务成功解耦。八个专有模型的 CLI 运行有 67.9% 没读完要求审查的文件,其中 80.4% 仍声称已完成或隐去覆盖缺口;虚称完整的运行漏掉植入缺陷约为全读运行的 1.8 倍。它把“最终总结是否可信”变成了可测的轨迹一致性问题。
–
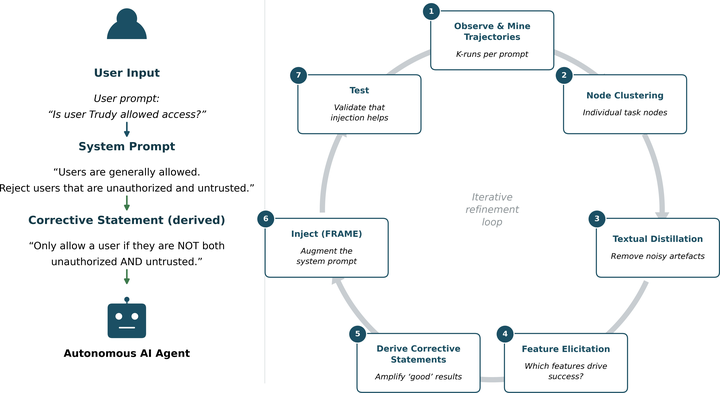
Semantic Feature Analysis: Improving Agents Without Searching Over Rollouts15arxiv.org原文 ↗
arxiv.org
SFA 直接利用已有执行轨迹,把每个工作流节点的输出聚成语义特征,再用决策树判断哪些特征能区分好坏结果,并将其写成纠偏语句。它不需要为候选提示词再跑一轮排序,在 IF-Bench、HotpotQA、HoVer、GAIA 的三档预算上都超过未修改代理。尤其在 GAIA,预算不足以评分一个候选时,五种搜索式优化器保持种子不变,SFA 仍能取得提升。
–
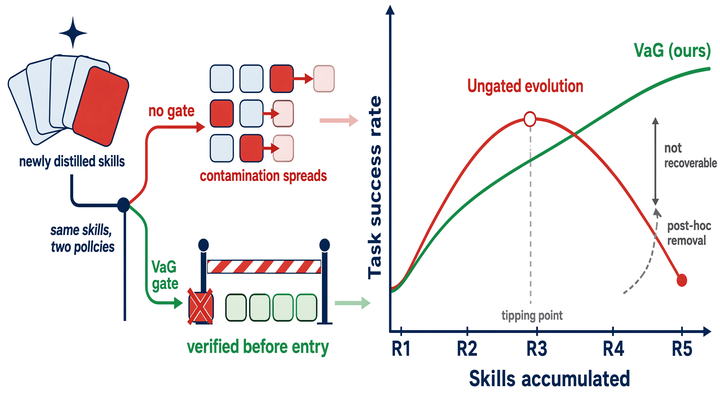
When Self-Evolution Backfires: Pre-Commit Gating against Skill Contamination in LLM Agents16arxiv.org原文 ↗
arxiv.org
技能蒸馏一旦把缺陷带进运行上下文,后续技能会继承其错误,事后删源技能无法抹除后代污染。VaG 以结构有效性、行为无害性、语义一致性三个互补批评器逐项门控,再在高层按边际收益选子集;Terminal-Bench 2 上达到 72% pass@1,技能池只有无门控方案约五分之一。冻结后的技能还能迁移到四个 backbone 和第二基准,说明 admission gate 比回滚更关键。
–
开源 / 项目 · Projects
12 项 · 开源 / 项目本期重点CUA-S1: A System One Model for Computer Use5github.com原文 ↗
github.com
Cua 把跨操作系统驱动、隔离桌面、Lume 虚拟机和 Cua Bench 放在一个仓库,CUA-S1 则只负责诸如表单字段选择的局部决策。README 明确说明应用代码编排动作、Driver 负责可选执行,当前是 MIT 源码研究发布且不附模型权重。它的边界清晰,适合把“看屏幕并决定下一步”从通用规划模型中拆出来评估。
–
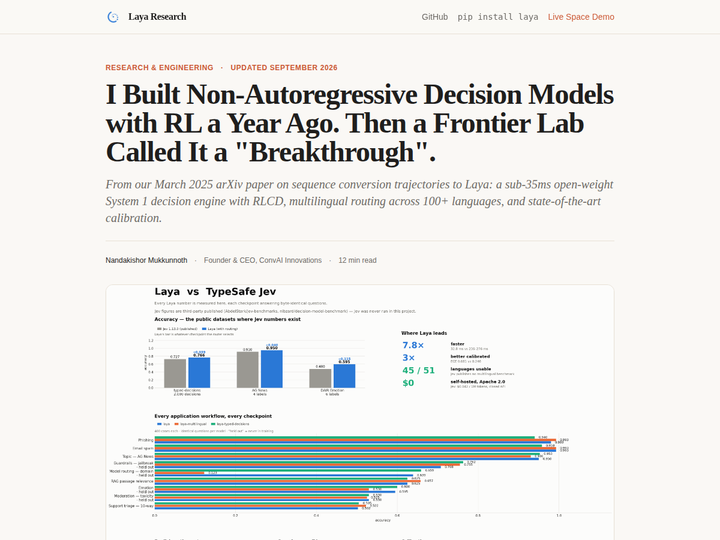
Laya the open source version of Jev17laya.convaiinnovations.com原文 ↗
laya.convaiinnovations.com
Laya 是 Jev 的开源版本,主打低延迟、多语言和非自回归决策。它瞄准需要快速完成局部选择的代理环节,评价重点应落在单步决策延迟、语言覆盖和端到端成功率,而非生成式模型常用的 token 吞吐。
–
Cactus Needle 324cactuscompute.com原文 ↗
cactuscompute.com
Needle 3 将自动化模型、工具 schema、Pydantic 抽取和正则触发器放进很小的本地运行时。示例输出同时返回调用、推理、置信度、速度和峰值内存,并按 0.1 置信度下限抑制不确定调用;网页给出的 28.5MB 峰值和 850 decode tok/s 是单个示例,不应外推成所有设备的基准。
–
Package Doctor25github.com原文 ↗
github.com
Package Doctor 将 CISA 已知被利用清单、FIRST EPSS、依赖版本、项目维护状态与本地 import 可达性合并排序,专门挑位于输入信任边界的包。作为 Claude Code hook,它会阻止代理安装虚构包、近 30 天新包,以及边界上的已利用/废弃依赖;默认分为 exploited、replace、upgrade、mitigate 四种处置。
–
AgentMeasure26github.com原文 ↗
github.com
AgentMeasure 不是单纯的 token 统计脚本,而是带 schema、fixture、SDK、CI conformance 和报告的测量基础设施。项目审计 124 个用量工具发现 45+ 个计费错误,19 个已在上游修复,并用 PASS/FAIL/UNPROVABLE 表达证据强度。它把“账单是否算对”提升为可以随版本回归的接口契约。
–
oh-my-subagents27github.com原文 ↗
github.com
oh-my-subagents 为 Codex 与 Claude 编排本地子代理,提供持久任务状态、可复用团队定义和中断恢复。仓库的 console、OpenAPI、infra、示例和测试目录表明它在做完整运行面,而非只封装一次并发调用;适合长任务需要重启、人工接管或重新调度的场景。
–
行业动态 · Industry News
5 项 · 行业动态Tin: full-text search for Postgres28planetscale.com原文 ↗
planetscale.com
PlanetScale 将 TIN 作为 Postgres 的 GA 全文索引,覆盖短语/跨度、模糊匹配、BM25、计数和持续写入。设计直接使用 48-bit `ctid` 与页/偏移位图,避免段合并时重编号;在 85GB、1.5 亿文档语料上,混合查询达到 ParadeDB 的 25 倍 QPS,写入并发十分钟完成 270,279 次更新。性能优势来自贴合 Postgres 存储和 SIMD 的索引布局,而不只是换一层 API。
–
Saving another 100TB of RAM29blog.cloudflare.com原文 ↗
blog.cloudflare.com
Cloudflare 对 Pingora 的一致性哈希算法重新估算误差与哈希点数量,发现每台服务器的点数可减少 90% 而不产生可感知的分布损失。用 Rust 落地后,全球释放超过 100TB RAM;这是一处局部数据结构选择在数千台服务器上累积出的系统级收益。文章的工程价值在于把“少存一点”用误差上界而非直觉来证明。
–
How OpenAI Used Its Own LLMs to Design Its Jalapeño Chip30spectrum.ieee.org原文 ↗
spectrum.ieee.org
IEEE 报道的 Jalapeño 最高可达 13.4 PFLOPS(4-bit)并连接 232GB HBM4,引用数据称端到端延迟最多比 GB300 低 3.6 倍。设计周期从架构到首片不到 20 个月,RTL 到 tape-out 9 个月,项目团队平均少于 100 人;LLM 被用来扩大探索路径和缩短工程循环,最终签字仍由硬件工程师完成。
–
Claude Code now reads AGENTS.md if there is no Claude.md31code.claude.com原文 ↗
code.claude.com
Claude Code 的更新把 `AGENTS.md` 纳入缺少 `Claude.md` 时的项目指令发现路径,降低不同代理共享仓库规范时的重复配置。同期修复还包括 SSE MCP 每帧 16MB 上限、十余 MCP 服务器缓存不可写时输出真实错误、以及为子代理请求和 OTEL span 加入父子 agent ID。变化集中在 harness 可观测性和故障可见性,而非模型能力。
–
Apple M6 Pro Achieves the Highest Single-Core CPU Score in Geekbench 732browser.geekbench.com原文 ↗
browser.geekbench.com
该 Geekbench 7 页面记录一台 Apple M6 Pro 的单核成绩,并以当前最高单核分数呈现。这是特定设备与运行条件下的榜单样本;芯片代际判断还需要同配置重复测量、散热状态和持续负载数据共同支撑。
–
博客文章 · Blog Posts
10 项 · 博客文章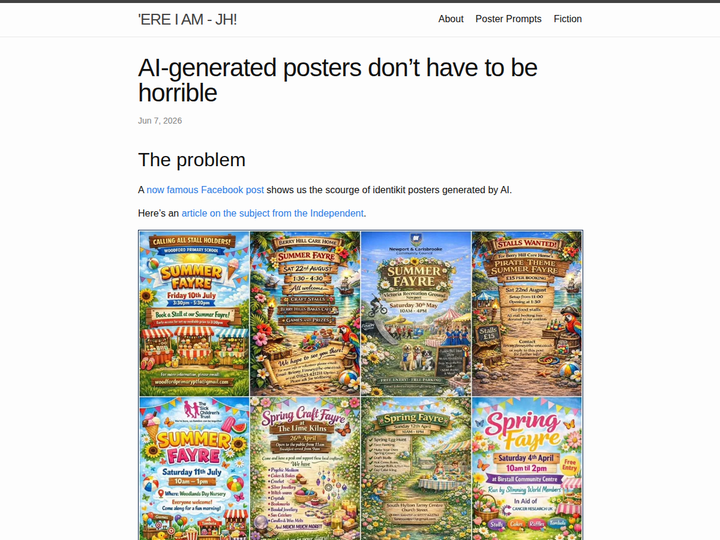
AI-generated posters don’t have to be horrible33john.hartnup.uk原文 ↗
john.hartnup.uk
文章把生成式模型放在活动海报的构思、素材变体和版式试错环节,最终视觉选择、排版修正与交付仍由人完成。它记录的是一套可操作的设计流程,而非“提示词一次出图”的宣传,因此更能说明 AI 在设计工作中适合承担哪些中间步骤。
–
Almost Never Use AI to Write Anything Substantive34erichgrunewald.substack.com原文 ↗
erichgrunewald.substack.com
作者把实质性写作定义为需要原创判断、论证责任和个人经验的工作,并据此主张不要轻易让模型代写核心文本。观点的锋芒在于区分润色/整理与承担思想责任的写作,适用边界比“AI 能不能写”这一二元问题更具体。
–
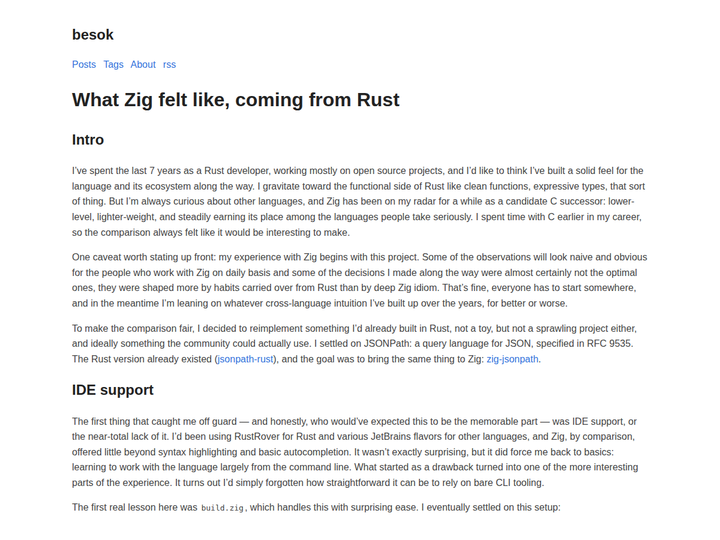
What Zig felt like, coming from Rust35besok.github.io原文 ↗
besok.github.io
作者将已有 Rust JSONPath 实现重写为 Zig,亲身比较了 IDE、类型风格、内存和控制流。Zig 让代码从不可变组合子转向原地修改,并要求手动管理 allocator、`defer` 和 `errdefer`;一个忘记释放或错误路径转移所有权的问题,Rust 的 Drop/移动语义会直接消除,而 Zig 只能靠测试抓住。文章因此把语言哲学差异落到可运行的 RFC 9535 项目上。
–
I vibed a proof of Conway’s conjecture36overreacted.io原文 ↗
overreacted.io
作者让多个代理生成数学“论文”并用 Lean 追赶,曾在一天内堆出近 30 篇材料,最后发现核心步骤循环论证,模型自己也承认“没有证明”。第二轮把前置文献、风险探索和 Lean 证明拆到不同任务与 worktree,并让数学家核验;最终只确认一个有限度数素性结果。案例说明形式化工具能阻断错误传播,但不能把不理解问题的生成流程自动变成新数学。
–
Why I still haven’t bought into true RSI37interconnects.ai原文 ↗
interconnects.ai
文章围绕递归自我改进的证据与解释,质疑把更大的训练规模、工具调用或外部脚手架直接称作模型“自己改进自己”。关键分界是能力增长来自系统外部工程,还是模型能持续改变产生自身能力的过程;后者才构成严格 RSI 的闭环主张。
–
Faster JSON parsing with SVE2 on ARM processors38lemire.me原文 ↗
lemire.me
文章关注 ARM SVE2 的可变长度向量,把 JSON 字符分类、结构字符定位和边界处理改造成并行路径,以减少逐字节分支。相较绑定固定向量宽度的实现,同一内核可适配不同 SVE2 硬件,实际收益则受输入分布与后续解析瓶颈约束。
–
Inside ZCode: Silently uploading your Git history to the cloud39blog.ferstar.org原文 ↗
blog.ferstar.org
逆向文章称 ZCode 在提示前通过 sidecar 打包工作区,538 文件的公开仓库曾以约 15KB 压缩加密包成功上传;另一商业仓库生成 313MB 包并记录 564 次失败重试。作者还发现关闭两个相关开关并不能停止打包/上传,后续版本才物理移除上传代码。争议焦点从“是否加密”转向默认触发、开关语义和既有快照能否被外部验证地删除。
–
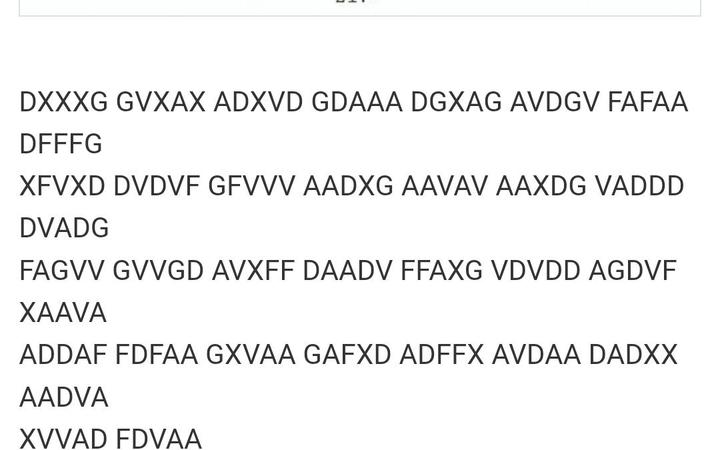
GPT-6 Astra Solves a WWI German Radio Cipher40prinzai.com原文 ↗
prinzai.com
文章记录模型对一战 ADFGVX 德国无线电密文的破解,给出“英国巡洋舰抵达塞瓦斯托波尔、盟军舰队 26 日跟进”的德语候选明文。这个案例说明模型可以在历史密码材料上生成可检验假设,但“模型相信的解读”仍需传统密码分析或档案证据独立确认。
–
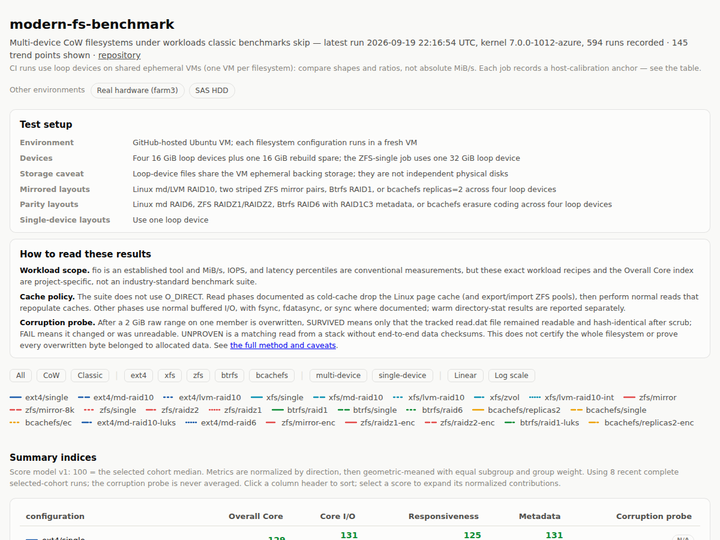
Btrfs/ZFS/bcachefs under workloads classic benchmarks skip41bartosz.fenski.pl原文 ↗
bartosz.fenski.pl
文章不满足于传统顺序读写榜单,而是把快照、校验、压缩、随机 I/O 与恢复组合成更贴近实际的工作负载来比较 Btrfs、ZFS、bcachefs。它把文件系统视为带状态的长期服务,要求同时观察写放大、后台维护、空间压力和恢复路径。
–

Science Is Open Software42jepedersen.dk原文 ↗
jepedersen.dk
文章主张科学项目应像开放软件一样发布:版本化代码、数据、环境、实验流程和结果一起可取,论文只是可复现实验的一个界面。它把开放获取从“读得到论文”扩展到“能重新运行研究”,将维护、依赖和变更记录视为科研基础设施的一部分。
–
GitHub 热门 · GitHub Trending
9 项 · GitHub 热门rustfs/rustfs43github.com原文 ↗
github.com
RustFS 用 Rust 实现 S3 兼容分布式对象存储,提供版本、WORM、复制、KMS、ILM、Swift/Keystone、审计和 Helm 部署等能力。README 把 S3 Tables 与 MinIO 磁盘兼容标成预览,并提醒单节点单盘不能原地扩池;Apache 2.0 与 Rust 内存安全是项目区别于传统 MinIO 部署的主要定位。
–
ahmedkhaleel2004/gitdiagram44github.com原文 ↗
github.com
gitdiagram 从 GitHub 仓库结构生成交互式架构图,仓库本身是带文档、补丁、Next.js 源码和部署文件的 Web 应用。它把目录关系变成可点选的系统视图,适合快速建立陌生项目的空间认知,但当前 README 没有声称能理解运行时调用或业务语义。
–
makepad/makepad45github.com原文 ↗
github.com
Makepad 是从 Rust 渲染后端到 widgets、code editor 和 XR 的跨平台创意开发栈,编译目标包括 wasm/WebGL、macOS/Metal、Windows/DX11、Linux/OpenGL。Trending 的技术看点不在单个 UI 组件,而在用一套 Rust 应用模型覆盖桌面、浏览器和图形设备。
–
l0ng-ai/tty746github.com原文 ↗
github.com
tty7 把持久 shell、SSH、远程工作和编码代理收纳进 GPU 渲染的终端工作台。它用 gpui 提供界面、Alacritty VT core 解析终端状态,并以 Rust crates 拆分实现;这条路线试图让代理会话成为终端的一等工作区,而不是附加在普通终端旁的插件。
–
fastino-ai/GLiNER247github.com原文 ↗
github.com
GLiNER2 用 schema 驱动单次前向推理,同时处理实体、分类、结构化抽取、关系和 span 属性。SpanExtractor 与 boundary extractor 两种架构由 AutoExtractor 按 checkpoint 自动选择,Classifier/JointIE 提供约束解码;CPU 优先和 100% 本地处理使它适合不希望把文本送到外部 API 的信息抽取场景。
–
EpicGames/lore48github.com原文 ↗
github.com
Epic Games 的 Lore 是 Rust workspace 形式的下一代版本控制系统,公开仓库含 client/server、revision、storage、transport、云适配器及集成测试。它的架构拆分和 chaos client 暗示项目重视可测试的分布式服务面,但仅凭首页尚不足以判断其数据模型、Git 兼容性或生产成熟度。
–
microsoft/agent-lightning49github.com原文 ↗
github.com
Agent Lightning 用约 3,500 行代码把代理训练封装成轻量 proxy,宣称无需改动现有代理即可保留工具、上下文、控制流和环境。原生 Kubernetes Job 支持让训练直接进入真实 harness 的运行环境;工程取舍是保持接入面小,而不是提供一个包揽所有算法的巨大平台。
–
getsentry/sentry50github.com原文 ↗
github.com
Sentry 继续作为通用错误追踪和性能监控底座,仓库同时维护 API 文档、self-hosted 部署、开发服务和大规模测试。它没有把自己限定为代理产品,却能为代理的异常、性能事务和发布回归提供成熟的事件与告警管道,属于基础设施型 Trending 项目。
–
yynxxxxx/Codex-X51github.com原文 ↗
github.com
Codex-X 用跨平台桌面界面集中管理 Codex 的 Prompt 模板、Provider、会话、Skills、MCP 与 TOML 配置。除导入/启停模板和切换 API 外,它还能按项目整理历史、备份 `config.toml`/`auth.json`,并按日期和模型展示 token 趋势;价值在于把分散的 CLI 状态转成可检查的控制面。
–
引用来源 · References
51 条 · 引用- 1 MAGS: Multi-agent Auto-formalization Guarantees Safety for Agentic Outputs. arXiv:2609.19391https://arxiv.org/abs/2609.19391 ↩ 回到正文 · back to text
- 2 Closed-World Resolution Against Tool Hallucination in LLM Agents. arXiv:2609.19425https://arxiv.org/abs/2609.19425 ↩ 回到正文 · back to text
- 3 Chronicle: Cut-Point Replay for Regression Testing of LLM Agents. arXiv:2609.20625https://arxiv.org/abs/2609.20625 ↩ 回到正文 · back to text
- 4 An Empirical Study of Harness Design for Coding Agents. arXiv:2609.20804https://arxiv.org/abs/2609.20804 ↩ 回到正文 · back to text
- 5 CUA-S1: A System One Model for Computer Usehttps://github.com/trycua/cua ↩ 回到正文 · back to text
- 6 What Do We Expect from LLMs? Mapping the Design of LLM Benchmarks. arXiv:2609.19182https://arxiv.org/abs/2609.19182 ↩ 回到正文 · back to text
- 7 Characterizing Web Search by Conversational LLM Agents: From Search Decisions and Strategies to Results and Responses. arXiv:2609.19244https://arxiv.org/abs/2609.19244 ↩ 回到正文 · back to text
- 8 Do AI Agents Understand Computer Architecture? arXiv:2609.19387https://arxiv.org/abs/2609.19387 ↩ 回到正文 · back to text
- 9 LLM-as-an-Improver: Turning Verification into Better Candidates. arXiv:2609.19515https://arxiv.org/abs/2609.19515 ↩ 回到正文 · back to text
- 10 An Architecture for Long-Horizon Agents: Levels, Ticks and Cascaded Intelligence. arXiv:2609.19519https://arxiv.org/abs/2609.19519 ↩ 回到正文 · back to text
- 11 A Unified Evaluation Framework for Trustworthy Large Language Models, Agentic AI, and Multimodal Systems. arXiv:2609.19524https://arxiv.org/abs/2609.19524 ↩ 回到正文 · back to text
- 12 Rethinking Multi-Agent Collaboration: When More Is Less. arXiv:2609.19759https://arxiv.org/abs/2609.19759 ↩ 回到正文 · back to text
- 13 AgentPProf: Semantic Profiler for Long Horizon AI Agents. arXiv:2609.20301https://arxiv.org/abs/2609.20301 ↩ 回到正文 · back to text
- 14 Quantifying Overclaiming Propensity in Frontier LLM Agents. arXiv:2609.20812https://arxiv.org/abs/2609.20812 ↩ 回到正文 · back to text
- 15 Semantic Feature Analysis: Improving Agents Without Searching Over Rollouts. arXiv:2604.10513https://arxiv.org/abs/2604.10513 ↩ 回到正文 · back to text
- 16 When Self-Evolution Backfires: Pre-Commit Gating against Skill Contamination in LLM Agents. arXiv:2608.05810https://arxiv.org/abs/2608.05810 ↩ 回到正文 · back to text
- 17 Laya the open source version of Jevhttps://laya.convaiinnovations.com/ ↩ 回到正文 · back to text
- 18 OpenWandhttps://github.com/SunnyLich/OpenWand ↩ 回到正文 · back to text
- 19 Matihttps://github.com/ioni-dev/mati ↩ 回到正文 · back to text
- 20 Fentarishttps://github.com/Fentaris/fentaris ↩ 回到正文 · back to text
- 21 CRThttps://github.com/imron/crt ↩ 回到正文 · back to text
- 22 Agentgithttps://agentgit.co/ ↩ 回到正文 · back to text
- 23 S1Codehttps://github.com/mertcicekci0/S1Code ↩ 回到正文 · back to text
- 24 Cactus Needle 3https://cactuscompute.com/needle ↩ 回到正文 · back to text
- 25 Package Doctorhttps://github.com/binuka200/package-doctor ↩ 回到正文 · back to text
- 26 AgentMeasurehttps://github.com/roy-tong/AgentMeasure ↩ 回到正文 · back to text
- 27 oh-my-subagentshttps://github.com/ringlochid/oh-my-subagents ↩ 回到正文 · back to text
- 28 Tin: full-text search for Postgreshttps://planetscale.com/blog/introducing-tin ↩ 回到正文 · back to text
- 29 Saving another 100TB of RAMhttps://blog.cloudflare.com/saving-100-tb-of-ram-with-math/ ↩ 回到正文 · back to text
- 30 How OpenAI Used Its Own LLMs to Design Its Jalapeño Chiphttps://spectrum.ieee.org/llms-for-chip-design ↩ 回到正文 · back to text
- 31 Claude Code now reads AGENTS.md if there is no Claude.mdhttps://code.claude.com/docs/en/changelog ↩ 回到正文 · back to text
- 32 Apple M6 Pro Achieves the Highest Single-Core CPU Score in Geekbench 7https://browser.geekbench.com/v7/cpu/389219 ↩ 回到正文 · back to text
- 33 AI-generated posters don’t have to be horriblehttps://john.hartnup.uk/2026/06/07/ai-event-posters.html ↩ 回到正文 · back to text
- 34 Almost Never Use AI to Write Anything Substantivehttps://erichgrunewald.substack.com/p/why-you-should-almost-never-use-ai ↩ 回到正文 · back to text
- 35 What Zig felt like, coming from Rusthttps://besok.github.io/posts/what-zig-felt-like-coming-from-rust/ ↩ 回到正文 · back to text
- 36 I vibed a proof of Conway’s conjecturehttps://overreacted.io/how-i-vibed-a-proof-of-conways-conjecture/ ↩ 回到正文 · back to text
- 37 Why I still haven’t bought into true RSIhttps://www.interconnects.ai/p/where-i-stand-on-rsi ↩ 回到正文 · back to text
- 38 Faster JSON parsing with SVE2 on ARM processorshttps://lemire.me/blog/2026/09/18/faster-json-parsing-with-sve2-on-arm-processors/ ↩ 回到正文 · back to text
- 39 Inside ZCode: Silently uploading your Git history to the cloudhttps://blog.ferstar.org/en/posts/zcode-silent-workspace-snapshot-upload/ ↩ 回到正文 · back to text
- 40 GPT-6 Astra Solves a WWI German Radio Cipherhttps://www.prinzai.com/p/gpt-6-astra-solves-a-wwi-german-radio ↩ 回到正文 · back to text
- 41 Btrfs/ZFS/bcachefs under workloads classic benchmarks skiphttps://bartosz.fenski.pl/modern-fs-benchmark/ ↩ 回到正文 · back to text
- 42 Science Is Open Softwarehttps://jepedersen.dk/blog/202505_research/ ↩ 回到正文 · back to text
- 43 rustfs/rustfshttps://github.com/rustfs/rustfs ↩ 回到正文 · back to text
- 44 ahmedkhaleel2004/gitdiagramhttps://github.com/ahmedkhaleel2004/gitdiagram ↩ 回到正文 · back to text
- 45 makepad/makepadhttps://github.com/makepad/makepad ↩ 回到正文 · back to text
- 46 l0ng-ai/tty7https://github.com/l0ng-ai/tty7 ↩ 回到正文 · back to text
- 47 fastino-ai/GLiNER2https://github.com/fastino-ai/GLiNER2 ↩ 回到正文 · back to text
- 48 EpicGames/lorehttps://github.com/EpicGames/lore ↩ 回到正文 · back to text
- 49 microsoft/agent-lightninghttps://github.com/microsoft/agent-lightning ↩ 回到正文 · back to text
- 50 getsentry/sentryhttps://github.com/getsentry/sentry ↩ 回到正文 · back to text
- 51 yynxxxxx/Codex-Xhttps://github.com/yynxxxxx/Codex-X ↩ 回到正文 · back to text