Do Not Trust the Benchmark: Limitations of General LLM Rankings and a Case for Task-Specific Evaluation
arxiv.org原文 ↗
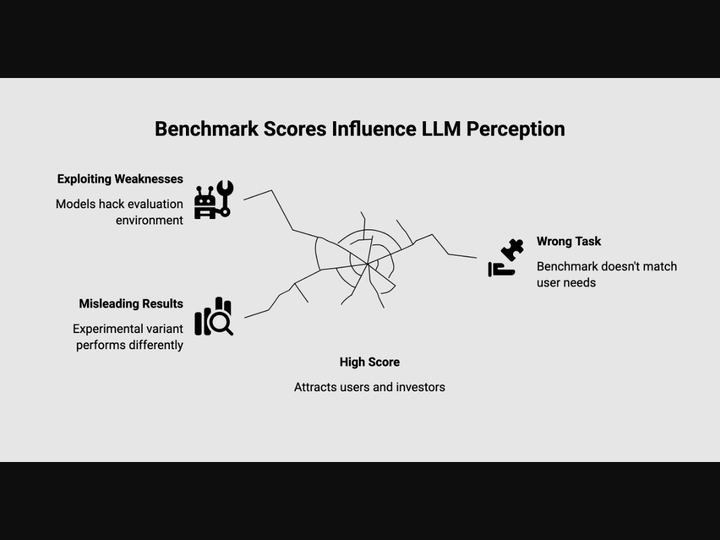
这篇立场论文把通用排名的失真归因到配置不透明、商业依赖、饱和与污染、迎合计分规则以及任务不相关,而不是简单归咎模型波动。它要求同时披露成本、时间、成功完成和泛化范围;Isotanta 的众包设计也被用来说明重复采样只能稳定估计,不能替代效度验证。
–浏览
评论 · Comments