MM-ContextFold: Context Folding for Multimodal Agentic Retrieval
arxiv.org原文 ↗
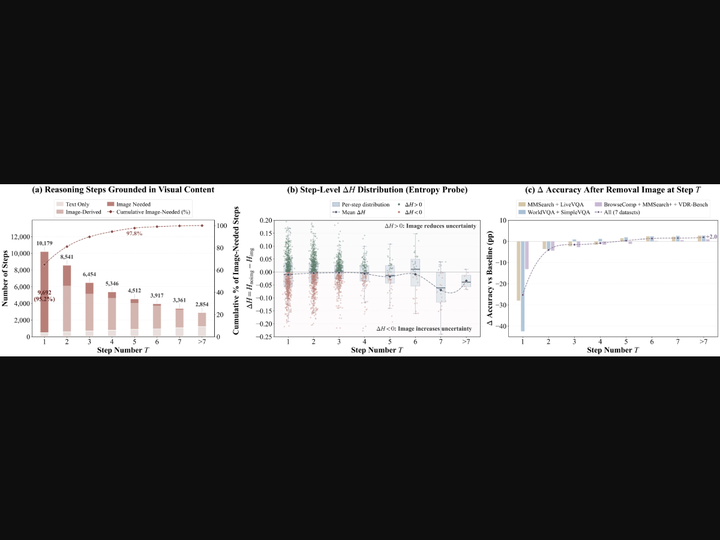
对约 10,000 条轨迹的分析显示,视觉线索被工具转成文字后继续保留原图反而提高输出熵。MM-ContextFold 用文本主上下文加临时图像分支,完成子任务后只回写摘要并丢弃分支;七个基准上平均准确率提高 6.3 个百分点,工作上下文缩短 27.5%。
–浏览
arxiv.org原文 ↗
评论 · Comments