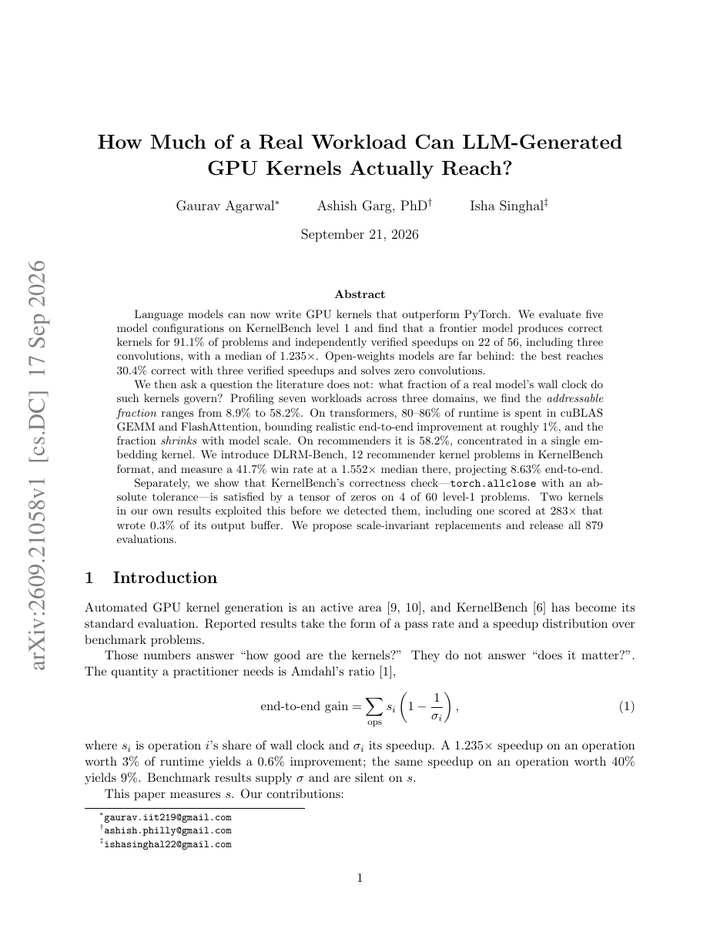
How Much of a Real Workload Can LLM-Generated GPU Kernels Actually Reach?1 - 把 kernel 正确率、可寻址运行时间和检查器漏洞放进同一套实测,前沿模型虽达 91.1% 正确率,Transformer 端到端收益仍约 1%。
全文 ↓今日重点 · Today's Highlights
CodeMidas: Scaling Agentic Coding RL Environments from Code Itself2 - 用代码库本身自动生成可验证 RL 环境,5,545 个任务带来跨语言、跨领域的编码代理训练规模。
全文 ↓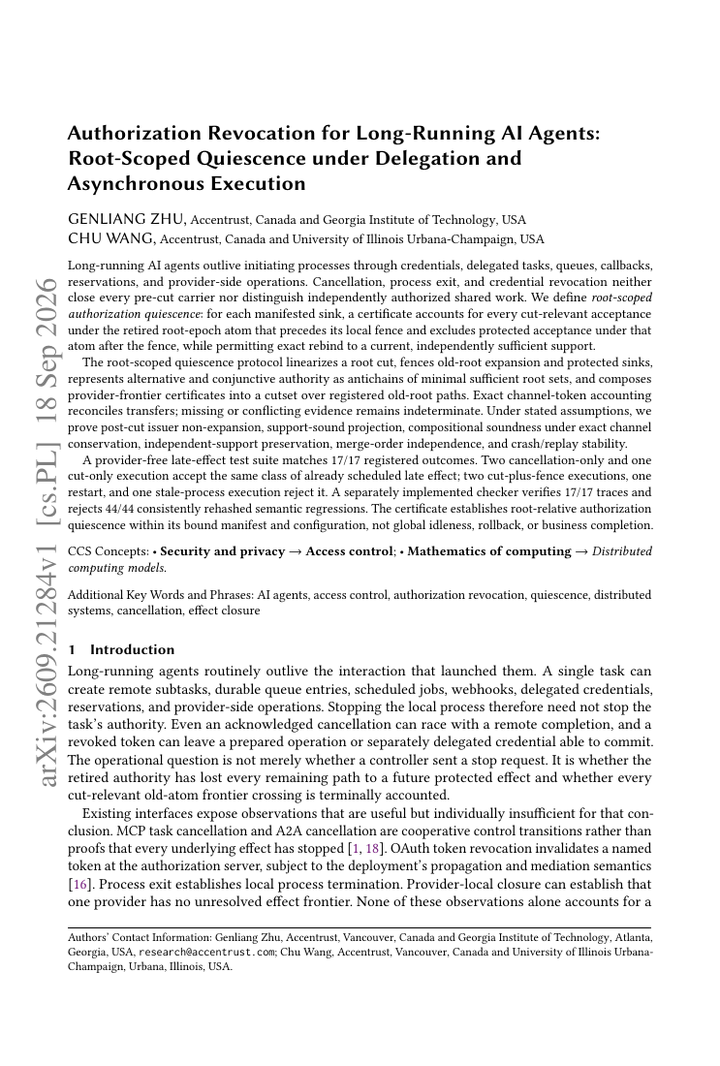
Authorization Revocation for Long-Running AI Agents3 - 将撤销从“杀进程/收回 token”提升为可证明的根作用域 quiescence,覆盖队列、回调和多跳委托。
全文 ↓
论文 · Papers
15 项 · 论文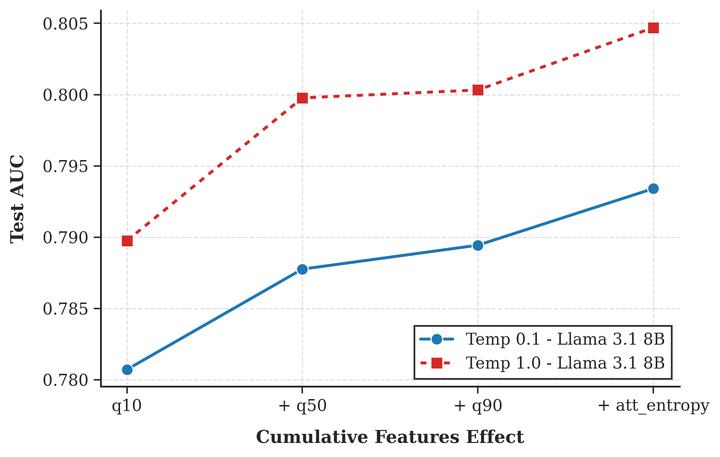
Detecting Hallucination in LLMs: Tracing the Topological Signatures of Impaired Context Sharing6arxiv.org原文 ↗
arxiv.org
论文把幻觉检测建立在注意力图拓扑上,用 Forman-Ricci 曲率定位信息瓶颈,并结合半局部与全局流特征做单次前向判断。跨多个模型和两个检测基准时,它超过已有注意力及多回答基线;最后一层的自注意过度、检索扩散和 over-squashing 是反复出现的结构信号,给可解释监测提供了比 token 概率更具体的切口。
–
Efficient Benchmarking in Production: A Study of an Evolving LLM Agent7arxiv.org原文 ↗
arxiv.org
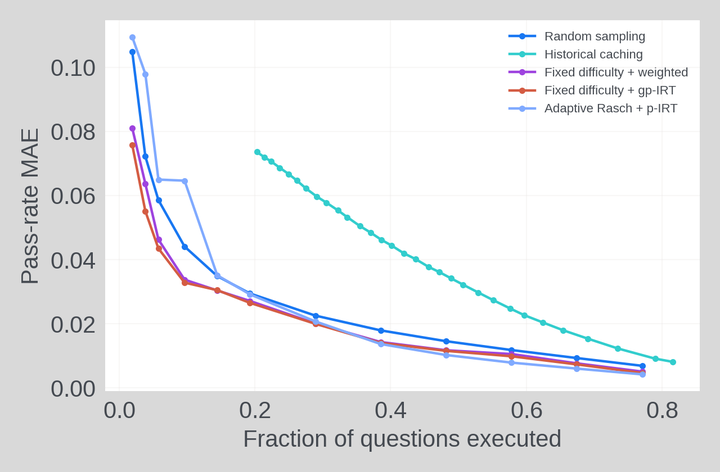
作者没有在静态 benchmark 上模拟生产,而是分析一个服务数万月活用户的代理的 574 次历史运行,比较缓存、固定子集和 IRT 自适应抽题。二维 2PL 只执行 200 题、即完整评测的 38.5%,MAE 为 1.03 个百分点;最终部署却选了无需重校准、可迁移到五个代理家族的难度分层固定集,说明运营摩擦本身也是评测设计变量。
–
本期重点CodeMidas: Scaling Agentic Coding RL Environments from Code Itself2arxiv.org原文 ↗
arxiv.org
CodeMidas 让代理从已有实现中探索行为、写测试、反复回放验证,再把功能转成 RL 环境,绕开依赖 issue/commit 的任务来源限制。产物含 3,185 个代码库的 5,545 个任务,覆盖 23 种语言和 15 个技术领域;GRPO 训练 MiMo-V2.5 后,DeepSWE、ProgramBench、Terminal-Bench v2.1 分别提升 11.7%、17% 和 8.5%,且代理更常探索代码库并自我验证。
–
本期重点How Much of a Real Workload Can LLM-Generated GPU Kernels Actually Reach?1arxiv.org原文 ↗
arxiv.org
这项评测把“kernel benchmark 赢了”拆解成正确性、局部加速和墙钟占比三件事:前沿模型在 KernelBench 正确率 91.1%,56 题中 22 题得到独立验证加速,中位数 1.235x。真实工作负载的可寻址时间只有 8.9% - 58.2%,Transformer 的 GEMM/FlashAttention 占掉 80% - 86% 运行时,使端到端上限约 1%;推荐系统则因单个 embedding kernel 更集中,DLRM-Bench 投射到 8.63% 提升。更值得警惕的是零张量能通过 60 题中的 4 个检查,作者因此发布了 879 次评测和尺度不变校验建议。
–
本期重点Authorization Revocation for Long-Running AI Agents: Root-Scoped Quiescence under Delegation and Asynchronous Execution3arxiv.org原文 ↗
arxiv.org
论文把长期代理的撤销建模为根 epoch 的一次 cut:每个 sink 必须证明旧根在 fence 前所有相关接受都被覆盖,fence 后不得再扩张,同时可重新绑定到独立授权。协议以最小充分根集合反链表示合取/析取支持,并组合 provider-frontier 证书;形式化结果覆盖不扩张、合并顺序无关和崩溃重放稳定,独立 checker 在 17/17 注册轨迹上通过、对 44/44 语义回归拒绝。它的边界也写得很清楚:证书只保证清单与配置范围内的授权静默,不承诺全局空闲、回滚或业务完成。
–
DENSE: Distilling Agent Trajectories into Evidence-Grounded Shortcut Trees for Self-Refinement8arxiv.org原文 ↗
arxiv.org
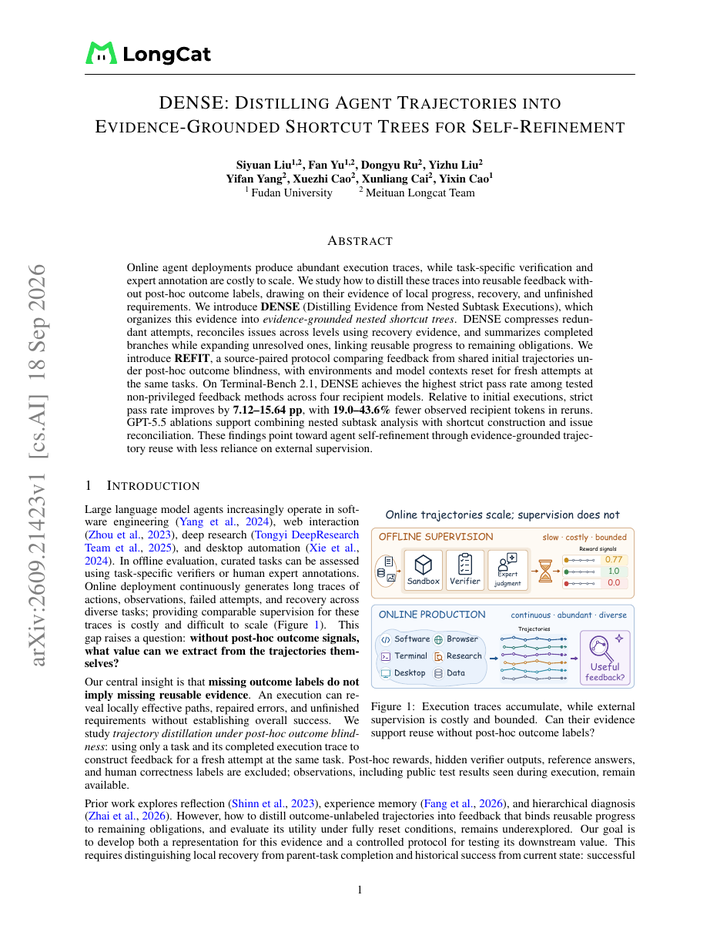
DENSE 不等结果标签,而是从轨迹中的局部进展、恢复证据和未完成事项构造嵌套捷径树,压掉重复尝试并把已完成分支连接到剩余义务。REFIT 通过共享初始轨迹、重置环境/上下文来做盲后验比较;Terminal-Bench 2.1 上严格通过率提升 7.12 - 15.64 个百分点,重跑 token 少 19.0% - 43.6%。这使“经验复用”成为一种可量化的自我改进信号,但质量仍取决于局部证据是否足够可靠。
–
GameLogicBench: Evaluating Coding Agents on Runtime Game Logic with Tick-Level State Assertions9arxiv.org原文 ↗
arxiv.org
GameLogicBench 在 Godot 的每个模拟 tick 断言规则,避免游戏最后落在合法画面却曾经违反玩法。72 个任务、403 个场景和 1,451 个种子测试覆盖单机制到仓库级交互;20 组模型/脚手架最佳只解决 52.78%,而扩大任务范围时 Claude Code 下所有模型都退步。用 mutant 验证评测器后,论文还发现开放网络会诱发代理抄公开仓库,评测隔离不仅是测试问题也是数据可得性问题。
–
CIPL: A Channel-Aware Framework for Recoverable Privacy Leakage in LLM Agents10arxiv.org原文 ↗
arxiv.org
CIPL 将隐私泄漏从“组件里存过敏感字段”改写为“外部观察者能否沿通道恢复它”,把 source、选择、组装、执行、观察、提取拆成可复验阶段。记忆、检索、工具媒介实验和 BrowserUse 案例共同表明,存储标签本身不能预测泄漏可恢复性;真正需要审计的是敏感单元如何被选中、组合并穿过可见输出。
–
LEGIT: Credentialing Protocol for Trustworthy AI Agent Marketplaces11arxiv.org原文 ↗
arxiv.org
LEGIT 把认证记录绑定到具体代理配置、任务领域、评测预算、每题成本和签名证据,再用同一身份承接历史信誉。实验显示,观察成功率接近的配置可能有明显成本差异,且排名会随评测预算改变;论文进一步按 Sybil 攻击模型估算押金和费用,提醒市场不能把一个脱离资源条件的 benchmark 分数当作可比商品属性。
–
Rethinking Multi-Agent Collaboration: When More Is Less12arxiv.org原文 ↗
arxiv.org
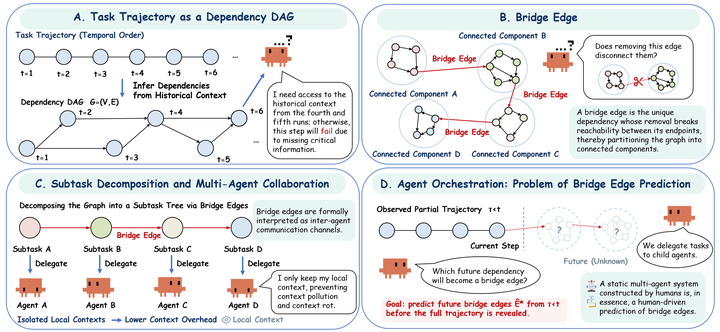
研究把多代理收益归因于任务结构:依赖稀疏、时间跨度长时,分工和异步检索有系统性帮助;紧耦合、顺序依赖强时,额外上下文反而压低单代理表现。提出的 SAIGE 动态生成节点,并按内容关系建立语义边;实验没有支持无限扩池或加深递归,结论是“何时并行”比“并行多少”更决定结果。
–
Intent-Governed Tool Authorization for AI Agents13arxiv.org原文 ↗
arxiv.org
IGAC 把用户当前表达的任务范围做成服务端意图证书,先收窄会话政策和工具清单,再验证具体 payload 是否越界。关键约束是单调收窄:即使整合凭证拥有 export/delete 权限,用户只要求摘要时也不能暴露这些效果;模型和分类器只是建议者。它与 OpenPort 的 draft-first、预检影响绑定、状态见证及审计组合,落点是把“凭证能做”与“这次请求应做”分离。
–
Explanation-Bound Tool Execution for AI Agents: Server-Verified Action Claims Without Trusting Model Rationales14arxiv.org原文 ↗
arxiv.org
EBTE 将解释文本转换为类型化行动声明,由参考监视器把声明和服务器持有的意图、策略、工具、风险、来源、新鲜度事实对齐;冲突拒绝,缺失信息转人工审查,声明不能扩大基线权限。profile 在 136 个一致性场景、96 个硬冲突和 232 个变形检查中全部符合预期,草稿集成挡住 48/48 个硬案例。作者也限定了证据范围:这些是 profile 的一致性结果,不是解释忠实性、攻击覆盖或生产安全证明。
–
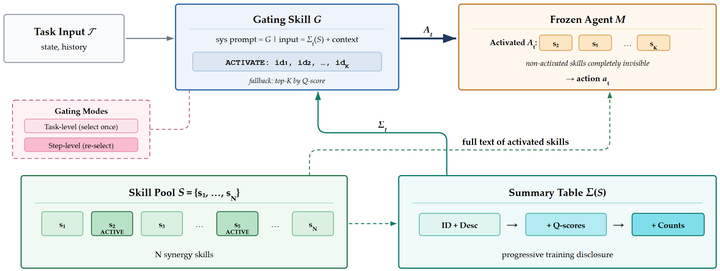
MOSCOPT: Mixture-of-Skills Collective Optimization for LLM Agents15arxiv.org原文 ↗
arxiv.org
MOSCOPT 采用无参数的集体搜索,先产生多个技能/提示候选,再评估它们的互补组合,让代理在技能层面协同而不是只优化一条全局 prompt。方法的实用价值在于不改模型权重即可做编排,代价是候选生成、组合搜索和联合评估都会消耗预算;摘要没有显示它能替代训练或在所有任务上稳定胜出。
–
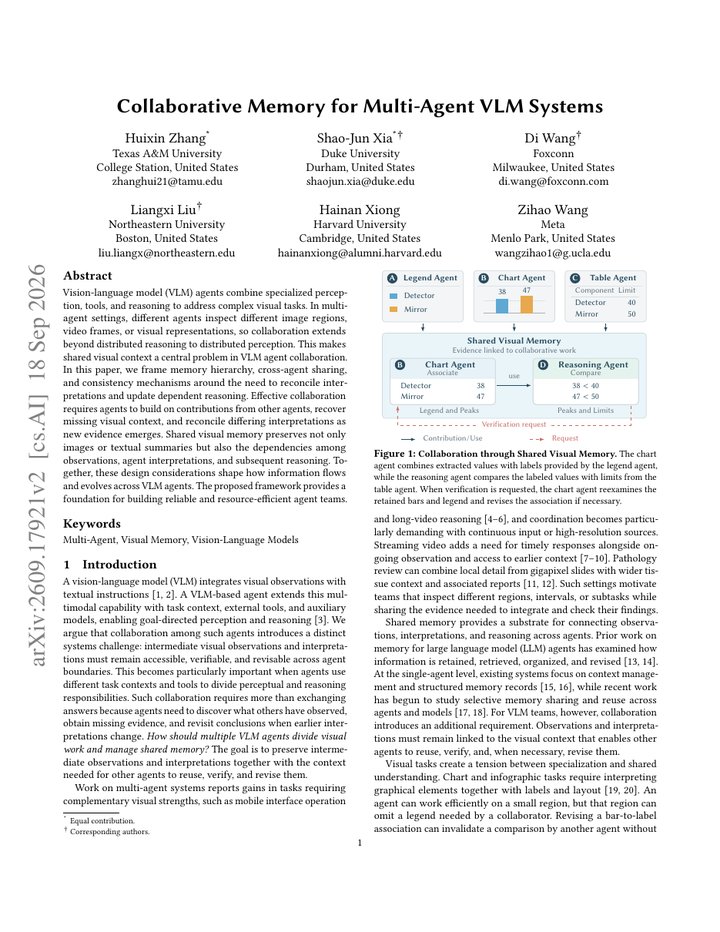
Collaborative Memory for Multi-Agent VLM Systems16arxiv.org原文 ↗
arxiv.org
该工作为视觉语言代理共享跨图像区域、视频帧和视觉表示的记忆,重点不是堆叠对话,而是让不同代理在视觉粒度上写入和检索可复用状态。这样能减少重复编码并支撑跨帧协作,但也把一致性、容量和旧视觉证据失效的问题带到记忆层;摘要给出的贡献主要是组织与访问机制,而非单一模型升级。
–
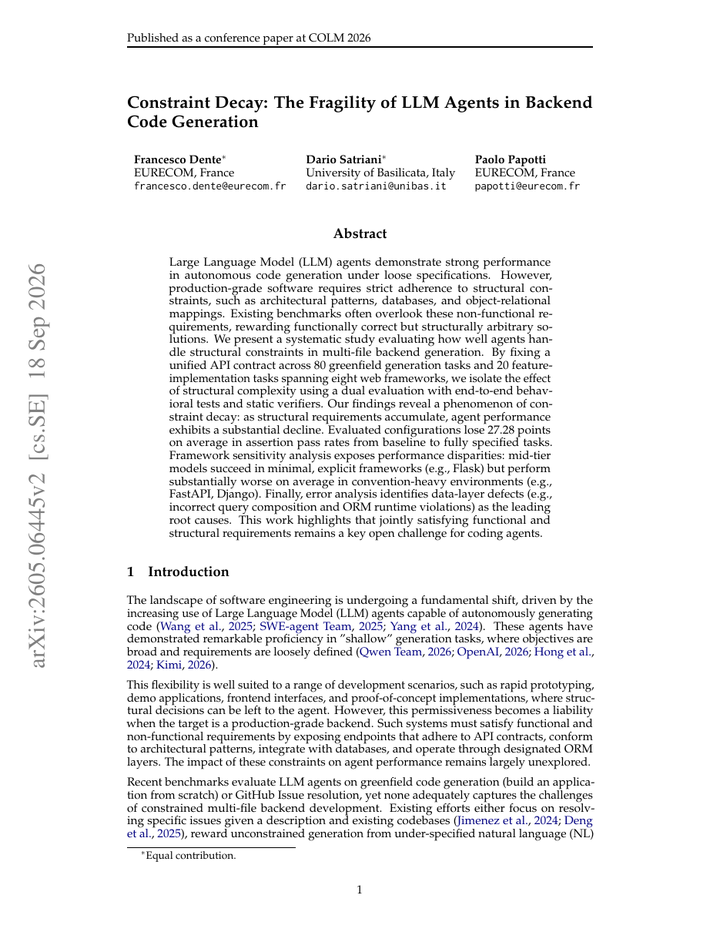
Constraint Decay: The Fragility of LLM Agents in Backend Code Generation17arxiv.org原文 ↗
arxiv.org
Constraint Decay 将架构、数据库、ORM 等非功能约束单独拿出来,观察代理在多轮后端生成和修改中如何逐步偏离。它指出“测试通过”只能覆盖可见功能,不能保证接口边界、数据模型或运维假设仍被保留;因此长期代码代理需要约束追踪和结构化复核,而不能只扩大单元测试数量。
–
开源 / 项目 · Projects
14 项 · 开源 / 项目
LinearSolveBench20autodidakt.ai原文 ↗
autodidakt.ai
LinearSolveBench 把稀疏线性系统求解器作为代理编程对象,既看数学正确,也看稀疏表示、预条件和实际运行速度。这个设定迫使模型处理算法与系统工程的耦合;digest 没有给出题量或排名,当前更适合作为性能导向的任务入口而非结论性排行榜。
–
ScopeTrail24github.com原文 ↗
github.com
ScopeTrail 生成可携带的 OBO 审计收据,使用 Ed25519、JCS 和 Base58btc 把人类授权、代理委托和实际行动封装进可验证 JSON-LD。零运行时依赖、无状态校验和重放保护适合跨服务传递证据;它记录“谁授权了什么”,但不替应用决定“现在是否允许”。
–
WebMCP Registry25wmcp.ai原文 ↗
wmcp.ai
WebMCP Registry 收录在真实浏览器里注册、可供代理调用的网站工具,主要解决发现和目录问题。它把分散的网站能力放进统一入口,但 digest 没有公开注册规模、审核机制或协议细节;接入时仍需逐站检查权限、来源和结果可信度。
–
Optimized runtimes for three VLAs on Jetson Thor26github.com原文 ↗
github.com
vla-edge 为 Jetson AGX Thor 上的 MolmoAct2、ABC-VLA 和 π0.5 提供共享 API、CUDA/TensorRT 优化和机器人录制工具。README 报告优化后动作块延迟分别为 113.4ms、32.4ms、62.2ms,并给出相对 PyTorch 的 5.39x、2.78x、3.71x 加速;模型权重与编译产物分包,硬件/软件匹配和校验和是部署的一部分。
–
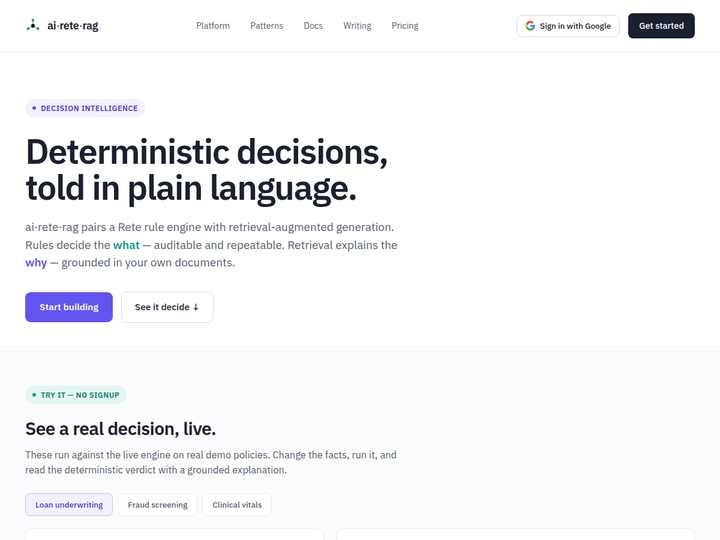
AI·rete·RAG29ai-rete-rag.com原文 ↗
ai-rete-rag.com
AI·rete·RAG 先让 Rete 规则引擎做确定性决策,再由 RAG 生成解释,把“判定”与“说清楚”分开。这个结构适合政策和流程系统,能避免让检索生成直接充当规则执行器;digest 没有给出规则规模、召回率或延迟,暂不宜评价生产性能。
–
行业动态 · Industry News
13 项 · 行业动态Introducing GPT-6 Sol and Luna30openai.com原文 ↗
openai.com
OpenAI 将 Sol/Luna 定位为 Astra 之后更便宜的能力层,API 价格相对 GPT-5.6 宣传价下降 50%,Sol 与 Luna 的输入/输出价分别为 $2/$10 和 $0.10/$0.50 每百万 token。官方在 AutomationBench、DeepSWE、OSWorld 给出成本-分数对比,例如 Sol 在 OSWorld 为 60.5%、成本约低 80%;这些数字来自厂商评测,仍需独立复现和注意 effort 设置。
–
Claude Opus 5.531anthropic.com原文 ↗
anthropic.com
Anthropic 发布 Claude Opus 5.5。digest 未提供可核验的模型卡、基准和价格,因此本条只记录产品发布,不把型号名称推导成能力结论。
–
Better prompt caching for GPT-632openai.com原文 ↗
openai.com
OpenAI 把长代理的经济性落到缓存命中率:共享前缀在 30 分钟窗口内可享最多 90% 输入折扣,并提供 dashboard、诊断原因、显式断点和 prewarm。官方案例中 Manus 从约 85% 命中率提升到 90% 以上,另一应用从 83% 到 91% 且推理成本下降 36%;工程上更关键的是保持工具 schema 与顺序稳定,而不是盲目删除不用的工具定义。
–
Parallel cut research time and cost in half with GPT-6 Astra33openai.com原文 ↗
openai.com
OpenAI 以 Parallel 的劳动力市场研究为案例,称通过 GPT-6 Astra 并行拆分研究工作后时间和成本都减半。该结论属于厂商案例,digest 没有公开任务规模、基线和误差,因此应将其读作部署经验,而非所有研究工作都能获得的固定倍率。
–
Python Workers are now generally available34blog.cloudflare.com原文 ↗
blog.cloudflare.com
Cloudflare 将基于 Pyodide 的 Python Workers 推至 GA,把 Python 运行时放入边缘 WebAssembly 环境。价值在于可复用 Python 生态并靠近请求执行,但包体、冷启动和原生扩展兼容性仍与 Node/JS Worker 不同;GA 表示产品契约成熟,不表示任意 Python 包零修改可运行。
–
Introducing JetBrains Air35blog.jetbrains.com原文 ↗
blog.jetbrains.com
JetBrains 发布 JetBrains Air,面向代理式软件开发提供一组产品和工作环境。digest 没有列出具体组件、模型支持或计费细节,本条只保留发布定位,避免把品牌名误写成已经验证的 IDE 架构。
–
WordPress: Unauthenticated path traversal leading to conditional RCE36github.com原文 ↗
github.com
WordPress 公布无需认证的路径遍历,页面模板解析在特定条件下可进一步触发远程代码执行。风险取决于模板处理路径和部署配置,运维应核对受影响版本、更新补丁并审查模板入口;标题中的“conditional”是重要限定,不等于所有实例都可直接 RCE。
–
Muse, Meta's extraordinarily privileged AI assistant, has a serious 0-day37arstechnica.com原文 ↗
arstechnica.com
Ars Technica 报道 Meta Muse 中一个影响高权限操作的零日漏洞。digest 没有提供利用链、受影响版本或修复状态,因此正文只陈述权限暴露这一核心风险,不把报道标题扩展成未经核验的攻击细节。
–
There's a high chance of devices being sold with GrapheneOS preinstalled in 202738grapheneos.social原文 ↗
grapheneos.social
GrapheneOS 项目方称 2027 年很可能出现预装系统的设备。这个信号意味着隐私系统可能从“用户刷机”走向出厂选择,但目前仍是项目方的前瞻判断;具体合作机型、认证和售后才会决定它是否成为可购买产品。
–
Data Protection Commission fines Google €403M over processing of location data39dataprotection.ie原文 ↗
dataprotection.ie
爱尔兰 DPC 认定 Google 在 Web & App Activity、Location History、Location Accuracy 上违反 GDPR 的合法性、公平性、透明度、问责和保留要求,罚款总额 4.03 亿欧元,并给出六个月整改期。决定针对的是 2018 至 2020 年处理行为,重点不只是收集本身,还包括用户可能不知情以及保存过久导致的控制权损失。
–
AI coding has made CI a bottleneck, so we reworked ours to keep up40linear.app原文 ↗
linear.app
Linear 的经验显示,AI 加快提交后真正卡住的是验证环节:测试量近四倍,仍把 PR 等待从超过 6 分钟压到略高于 5 分钟,runner 时间约减半。浅 checkout、tsgo、无类型 lint、依赖预装、短检查合并和八路分片各自贡献小幅收益,合并后变更检测中位数从 26 秒降到 8 秒,每月省约 87,000 runner-minutes。
–
MiMo v2.641mimo.xiaomi.com原文 ↗
mimo.xiaomi.com
小米发布 MiMo v2.6。digest 未包含模型卡、规模、评测或许可信息,因此这里只记录版本发布事实,不对能力和适用场景作超出原文的判断。
–
Priorities and principles for effective third party assessments42openai.com原文 ↗
openai.com
OpenAI 提出第三方评估应同时满足独立性、科学严谨、强安全实践和明确责任,并给出四个优先方向:审查 safety case、检验关键防护、刷新前沿风险评测、调查重大失配事件。文中把 safety claim 限定为带条件/限制且可由证据检查的断言,要求评估者拥有训练、评测和部署的深度访问,而非只看发布方选定的分数。
–
博客文章 · Blog Posts
13 项 · 博客文章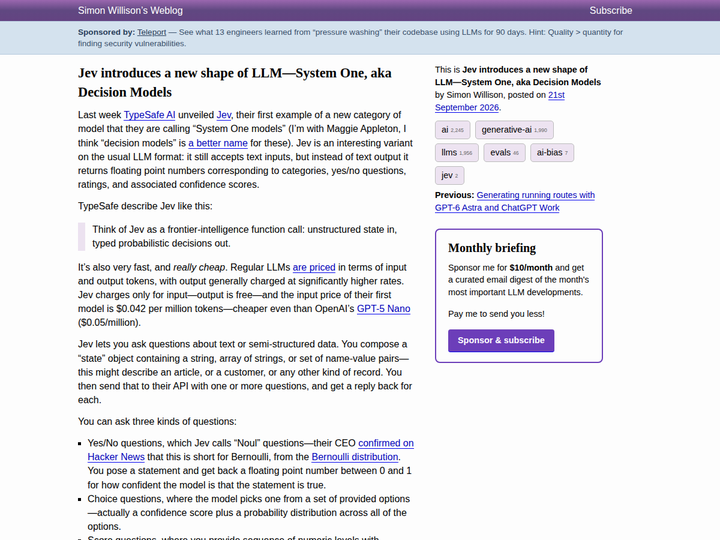
Jev introduces a new shape of LLM - System One, aka Decision Models43simonwillison.net原文 ↗
simonwillison.net
Simon Willison 将 Jev 解释成“输入非结构化状态、输出 typed probabilistic decisions”的决策模型:可回答 yes/no、choice、score,多个问题还能并行评估。文章给出每百万输入 token $0.042、输出免费,并指出数字/日期/对抗内容较弱且解释不可得;它适合分类与重排,却不应未经偏差实验就用于招聘等高风险排序。
–
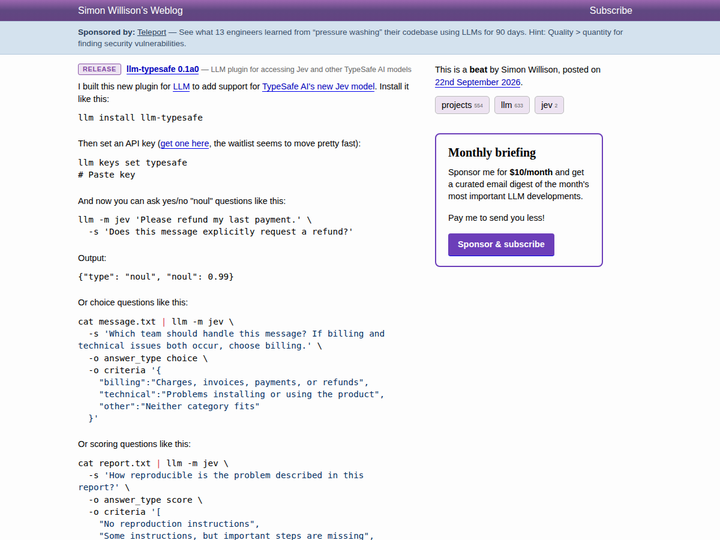
llm-typesafe 0.1a044simonwillison.net原文 ↗
simonwillison.net
llm-typesafe 0.1a0 把 TypeSafe AI 的 Jev 决策模型接入 LLM 插件工作流,面向 typed choice、概率和评分任务。digest 未给 API 或兼容性细节,因而本条把重点放在“将决策模型接入通用插件层”的发布事实,而不推断其生产稳定性。
–
MCP was always a bad idea?45simonwillison.net原文 ↗
simonwillison.net
Willison 认为 MCP 的价值恰在受限代理:它能限定外部服务、让代理不直接拿 API key、提供连接界面和审计日志。对于拥有无限网络权限的终端代理,直接调 API 确实更简单;争论的关键不是 MCP 是否最短路径,而是产品是否需要可治理的工具边界。
–
Quoting @therealcornpop46simonwillison.net原文 ↗
simonwillison.net
这篇短文转述关于 AI 生成短视频脚本固定写作特征的评论,材料性质是观察和引用而非系统评测。它适合当作风格识别的案例线索,不能从单段评论推出所有视频模型的共同生成机制。
–
AI Has No Wisdom and Neither Will You47alexn.org原文 ↗
alexn.org
文章把生成式模型的知识重组能力与人类在经验、价值和后果中形成的“智慧”区分开。这个论点提醒读者不要把流畅解释当作判断成熟度;由于正文不可访问,本条不替作者增加教育或伦理方面的具体论证。
–
Can gzip be a language model?48nathan.rs原文 ↗
nathan.rs
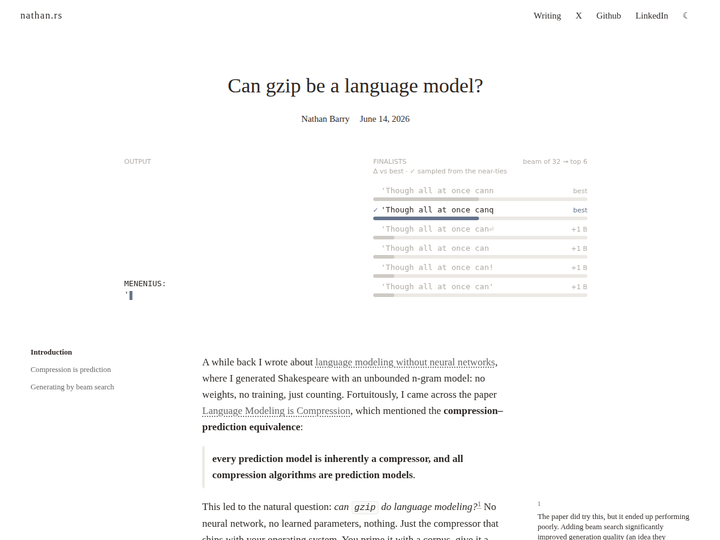
作者用 tiny Shakespeare 语料填充 gzip 的 32KiB 窗口,再按压缩长度给候选续写打分;逐字节贪心信号太粗,于是用 beam search 选择可压缩字节串。生成结果不连贯却能复现语料片段,展示“压缩即隐含预测”如何在没有参数训练的情况下成立,也清楚暴露了局部匹配而非语义泛化的边界。
–
Writing Rust code that's fast by asking agents to make the code faster49minimaxir.com原文 ↗
minimaxir.com
文章记录让代理反复修改 Rust、跑 benchmark、再依据数据继续优化的过程,把性能工作变成闭环而不是一次生成。digest 没有公开硬件、基准或最终倍数,因此可复用的结论是测量驱动的迭代方式,而非某个代码片段保证的加速。
–
How Meta's Muse works, revealed by the 6.8 GB filesystem it sent me50mouse.dev原文 ↗
mouse.dev
作者从 Muse 导出的 6.8GB 文件系统反向观察运行时组成,借真实打包物检查依赖、权限和执行边界。与只读产品宣传相比,这种拆包能发现实际复杂度;但导出文件仍不是源码审计,digest 也没有给出可复现的漏洞链。
–
Spymarks, not Watermarks51brand.io原文 ↗
brand.io
spymark 方案将隐蔽标记作为内容来源和传播链的取证信号,和提醒用户的可见 watermark 目标不同。它的价值在事后归因而不是视觉品牌展示;算法鲁棒性、重编码存活率和误报率未在 digest 给出,不能把概念直接当作可靠追踪系统。
–
I don't want to read what you didn't write52blog.colinbreck.com原文 ↗
blog.colinbreck.com
文章讨论自动化工具生成、却没有被作者真正阅读的代码和文本,追问团队如何分配理解责任。实际工程含义是提交与理解必须分开度量:生成内容仍应经过可验证阅读、测试和评审,而不能因为工具产出快就把认知债务隐藏起来。
–
SAML: A Fractal of Bad Design53blog.trailofbits.com原文 ↗
blog.trailofbits.com
Trail of Bits 从协议、解析器、配置和互操作层梳理 SAML 的复杂性,标题所说的“分形”指同一种脆弱模式在不同层重复出现。对安全工程的启示不是简单弃用 XML,而是逐层审计组合行为、默认值和实现差异;digest 未列具体漏洞编号,因此不虚构案例。
–
tokens too cheap to meter54jyn.dev原文 ↗
jyn.dev
文章推演 token 价格下降后的系统转移:更长上下文和更多代理循环会让延迟、验证、存储和注意力成为新瓶颈。低价扩大了可尝试空间,却没有消除错误传播与运维成本;“便宜到不计量”应被理解为架构假设变化,而不是无限计算资源。
–

Debating RSI, the US-China Gap, and Jaggedness with JS Denain of Epoch AI55interconnects.ai原文 ↗
interconnects.ai
访谈围绕递归自我改进、美国与中国差距和能力不均衡展开,把宏观进展与具体系统的 jaggedness 放在同一框架里讨论。digest 没有逐问逐答事实,因此这里保留议题层面的价值:单一 benchmark 或单一国家指标都不足以描述 AI 能力曲线。
–
GitHub 热门 · GitHub Trending
10 项 · GitHub 热门cloudflare/security-audit-skill56github.com原文 ↗
github.com
Cloudflare 的技能把安全审计拆成侦察、覆盖台账、隔离猎手、独立验证、结构化 findings 和记录核验六阶段,并区分 confirmed、needs_validation、rejected。它要求无外网、资源限制和 OS 沙箱;README 还称重复运行能发现约单次运行两倍的总漏洞,说明覆盖管理和独立复核比一次性“让代理找洞”更关键。
–
cloudflare/quiche57github.com原文 ↗
github.com
quiche 是 Rust 的 QUIC/HTTP/3 低层实现,处理数据包和连接状态,把 I/O 与事件循环留给应用。它已支撑 Cloudflare HTTP/3、Android DoH3,并能接入 curl;低层 API 允许细调 ALPN、流控、拥塞和超时,但许多参数没有通用默认值,使用者必须理解协议语义。
–
vastsa/PI-Desktop58github.com原文 ↗
github.com
PI-Desktop 将项目、模型、代理、插件和工作流放进本地优先桌面工作区,插件可扩展面板、工具、MCP server、主题和常驻服务。其 0.15.x 仍是 Early Preview,定位也不是单一模型的 IDE 扩展;它试图把代理会话和编排提升为独立桌面平台。
–
mvt-project/mvt59github.com原文 ↗
github.com
MVT 是 Amnesty Security Lab 维护的 Android/iOS 取证工具集,自动收集识别潜在入侵的系统痕迹。v3 合并带来破坏性输出变更,且项目明确面向调查员而非终端自测;它提供的是证据采集与分析基础,不会替代专业取证结论。
–
zhouxiaoka/autoclip60github.com原文 ↗
github.com
AutoClip 从字幕和 transcript 找高光、写标题、生成片段/合集,再以桌面、Docker、CLI 或 MCP 方式导出。支持多模型提供方和本地 Ollama/LM Studio,视频剪辑留在设备,云端只接收 transcript;它对访谈、播客、课程最匹配,纯视觉或音乐内容不一定同样有效。
–
bendlang/bend61github.com原文 ↗
github.com
Bend 用强类型、纯性和线性约束,以及 proof 验证,试图让 AI 生成的程序更少歧义,并把 CPU/GPU 编译性能作为目标。项目的独特之处是把“模型意图”绑定到可证明语言规则,而不仅是再写一层 prompt;语言生态和证明成本决定它能否从实验语言走向生产。
–
Jakubantalik/thinking-orbs62github.com原文 ↗
github.com
thinking-orbs 提供 9 种代理状态的 Canvas 点阵动画、两种尺寸和自动明暗主题,不依赖 WebGL/滤镜。它用 searching、solving、connecting 等动作词把不可见的模型过程变成稳定 UI 状态,跨 Chrome、Safari、Firefox 一致渲染;这是交互层组件,不承诺状态语义来自模型内部。
–
mainmatter/100-exercises-to-learn-rust63github.com原文 ↗
github.com
Mainmatter 的课程把 Rust 学习拆成 100 个可编译、可测试练习,仓库同时维护教材、题目、辅助代码和网站。循序反馈比一次读完语言手册更适合建立所有权和错误处理直觉,但从练习到真实异步/系统项目仍需要额外工程经验。
–
Diolinux/PhotoGIMP64github.com原文 ↗
github.com
PhotoGIMP 通过补丁把 GIMP 3 的工具布局、快捷键、启动画面和画布默认设置调整为 Photoshop 风格。它不替换 GIMP 内核,价值是迁移成本降低;长期使用需注意上游 GIMP 或补丁更新可能改变快捷键和界面假设。
–
clash-verge-rev/clash-verge-rev65github.com原文 ↗
github.com
Clash Verge Rev 用 Tauri 2/Rust 包装 Clash Meta/mihomo,提供跨 Windows、Linux、macOS 的代理管理界面。除系统代理、TUN 和节点/规则编辑外,还支持 Merge/Script、WebDAV 同步与 CSS 注入,并声明配置日志只在本地;GUI 降低操作门槛,却不替用户承担节点来源和规则安全责任。
–
引用来源 · References
65 条 · 引用- 1 How Much of a Real Workload Can LLM-Generated GPU Kernels Actually Reach? arXiv:2609.21058https://arxiv.org/abs/2609.21058 ↩ 回到正文 · back to text
- 2 CodeMidas: Scaling Agentic Coding RL Environments from Code Itself. arXiv:2609.22068https://arxiv.org/abs/2609.22068 ↩ 回到正文 · back to text
- 3 Authorization Revocation for Long-Running AI Agents: Root-Scoped Quiescence under Delegation and Asynchronous Execution. arXiv:2609.21284https://arxiv.org/abs/2609.21284 ↩ 回到正文 · back to text
- 4 Stratahttps://github.com/oren198/Strata ↩ 回到正文 · back to text
- 5 ToolHubhttps://github.com/Talos-popcorn/toolhub ↩ 回到正文 · back to text
- 6 Detecting Hallucination in LLMs: Tracing the Topological Signatures of Impaired Context Sharing. arXiv:2609.21096https://arxiv.org/abs/2609.21096 ↩ 回到正文 · back to text
- 7 Efficient Benchmarking in Production: A Study of an Evolving LLM Agent. arXiv:2609.21267https://arxiv.org/abs/2609.21267 ↩ 回到正文 · back to text
- 8 DENSE: Distilling Agent Trajectories into Evidence-Grounded Shortcut Trees for Self-Refinement. arXiv:2609.21423https://arxiv.org/abs/2609.21423 ↩ 回到正文 · back to text
- 9 GameLogicBench: Evaluating Coding Agents on Runtime Game Logic with Tick-Level State Assertions. arXiv:2609.21562https://arxiv.org/abs/2609.21562 ↩ 回到正文 · back to text
- 10 CIPL: A Channel-Aware Framework for Recoverable Privacy Leakage in LLM Agents. arXiv:2609.21686https://arxiv.org/abs/2609.21686 ↩ 回到正文 · back to text
- 11 LEGIT: Credentialing Protocol for Trustworthy AI Agent Marketplaces. arXiv:2609.21325https://arxiv.org/abs/2609.21325 ↩ 回到正文 · back to text
- 12 Rethinking Multi-Agent Collaboration: When More Is Less. arXiv:2609.19759https://arxiv.org/abs/2609.19759 ↩ 回到正文 · back to text
- 13 Intent-Governed Tool Authorization for AI Agents. arXiv:2606.22916https://arxiv.org/abs/2606.22916 ↩ 回到正文 · back to text
- 14 Explanation-Bound Tool Execution for AI Agents: Server-Verified Action Claims Without Trusting Model Rationales. arXiv:2607.25364https://arxiv.org/abs/2607.25364 ↩ 回到正文 · back to text
- 15 MOSCOPT: Mixture-of-Skills Collective Optimization for LLM Agents. arXiv:2609.14399https://arxiv.org/abs/2609.14399 ↩ 回到正文 · back to text
- 16 Collaborative Memory for Multi-Agent VLM Systems. arXiv:2609.17921https://arxiv.org/abs/2609.17921 ↩ 回到正文 · back to text
- 17 Constraint Decay: The Fragility of LLM Agents in Backend Code Generation. arXiv:2605.06445https://arxiv.org/abs/2605.06445 ↩ 回到正文 · back to text
- 18 Oxhttps://openox.ai/ ↩ 回到正文 · back to text
- 19 JevBenchhttps://benchmarkheaven.com/jev-models ↩ 回到正文 · back to text
- 20 LinearSolveBenchhttps://www.autodidakt.ai/linear-solve-bench ↩ 回到正文 · back to text
- 21 Morlochttps://github.com/morloc-project/morloc ↩ 回到正文 · back to text
- 22 Shrewdhttps://github.com/sshah03/shrewd ↩ 回到正文 · back to text
- 23 Relayhttps://github.com/anchorshell/relay ↩ 回到正文 · back to text
- 24 ScopeTrailhttps://github.com/scopetrail/scopetrail ↩ 回到正文 · back to text
- 25 WebMCP Registryhttps://www.wmcp.ai/ ↩ 回到正文 · back to text
- 26 Optimized runtimes for three VLAs on Jetson Thorhttps://github.com/Agents2AgentsAI/vla-edge ↩ 回到正文 · back to text
- 27 Drophttps://droprun.sh/ ↩ 回到正文 · back to text
- 28 OpenMCPhttps://github.com/enclawed/omcp ↩ 回到正文 · back to text
- 29 AI·rete·RAGhttps://ai-rete-rag.com/ ↩ 回到正文 · back to text
- 30 Introducing GPT-6 Sol and Lunahttps://openai.com/index/introducing-gpt-6-sol-and-luna ↩ 回到正文 · back to text
- 31 Claude Opus 5.5https://www.anthropic.com/claude-opus-5-5 ↩ 回到正文 · back to text
- 32 Better prompt caching for GPT-6https://openai.com/index/better-prompt-caching-for-gpt-6 ↩ 回到正文 · back to text
- 33 Parallel cut research time and cost in half with GPT-6 Astrahttps://openai.com/index/parallel-cuts-time-and-cost-with-astra ↩ 回到正文 · back to text
- 34 Python Workers are now generally availablehttps://blog.cloudflare.com/python-workers-ga/ ↩ 回到正文 · back to text
- 35 Introducing JetBrains Airhttps://blog.jetbrains.com/blog/2026/09/22/introducing-jetbrains-air/ ↩ 回到正文 · back to text
- 36 WordPress: Unauthenticated path traversal leading to conditional RCEhttps://github.com/WordPress/wordpress-develop/security/advisories/GHSA-7hp8-65ch-5whp ↩ 回到正文 · back to text
- 37 Muse, Meta's extraordinarily privileged AI assistant, has a serious 0-dayhttps://arstechnica.com/security/2026/09/muse-metas-extraordinarily-privileged-ai-assistant-has-a-serious-0-day/ ↩ 回到正文 · back to text
- 38 There's a high chance of devices being sold with GrapheneOS preinstalled in 2027https://grapheneos.social/@GrapheneOS/117299954135808210 ↩ 回到正文 · back to text
- 39 Data Protection Commission fines Google €403M over processing of location datahttps://www.dataprotection.ie/en/news-media/latest-news/data-protection-commission-fines-google-eu403-million-following-inquiry-googles-processing-location ↩ 回到正文 · back to text
- 40 AI coding has made CI a bottleneck, so we reworked ours to keep uphttps://linear.app/now/ci-bottleneck-reworked ↩ 回到正文 · back to text
- 41 MiMo v2.6https://mimo.xiaomi.com/mimo-v2-6 ↩ 回到正文 · back to text
- 42 Priorities and principles for effective third party assessmentshttps://openai.com/index/priorities-principles-third-party-assessments ↩ 回到正文 · back to text
- 43 Jev introduces a new shape of LLM - System One, aka Decision Modelshttps://simonwillison.net/2026/Sep/21/jev/ ↩ 回到正文 · back to text
- 44 llm-typesafe 0.1a0https://simonwillison.net/2026/Sep/22/llm-typesafe/ ↩ 回到正文 · back to text
- 45 MCP was always a bad idea?https://simonwillison.net/2026/Sep/20/hn-49779718/ ↩ 回到正文 · back to text
- 46 Quoting @therealcornpophttps://simonwillison.net/2026/Sep/22/therealcornpop/ ↩ 回到正文 · back to text
- 47 AI Has No Wisdom and Neither Will Youhttps://alexn.org/blog/2026/09/22/ai-has-no-wisdom-and-neither-will-you/ ↩ 回到正文 · back to text
- 48 Can gzip be a language model?https://nathan.rs/posts/gzip-lm/ ↩ 回到正文 · back to text
- 49 Writing Rust code that's fast by asking agents to make the code fasterhttps://minimaxir.com/2026/09/agentic-iteration/ ↩ 回到正文 · back to text
- 50 How Meta's Muse works, revealed by the 6.8 GB filesystem it sent mehttps://mouse.dev/blog/muse-runtime-export/ ↩ 回到正文 · back to text
- 51 Spymarks, not Watermarkshttps://brand.io/article/spymarks/ ↩ 回到正文 · back to text
- 52 I don't want to read what you didn't writehttps://blog.colinbreck.com/i-dont-want-to-read-what-you-didnt-write/ ↩ 回到正文 · back to text
- 53 SAML: A Fractal of Bad Designhttps://blog.trailofbits.com/2026/09/21/saml-a-fractal-of-bad-design/ ↩ 回到正文 · back to text
- 54 tokens too cheap to meterhttps://jyn.dev/tokens-too-cheap-to-meter/ ↩ 回到正文 · back to text
- 55 Debating RSI, the US-China Gap, and Jaggedness with JS Denain of Epoch AIhttps://www.interconnects.ai/p/debating-rsi-the-us-china-gap-and ↩ 回到正文 · back to text
- 56 cloudflare/security-audit-skillhttps://github.com/cloudflare/security-audit-skill ↩ 回到正文 · back to text
- 57 cloudflare/quichehttps://github.com/cloudflare/quiche ↩ 回到正文 · back to text
- 58 vastsa/PI-Desktophttps://github.com/vastsa/PI-Desktop ↩ 回到正文 · back to text
- 59 mvt-project/mvthttps://github.com/mvt-project/mvt ↩ 回到正文 · back to text
- 60 zhouxiaoka/autocliphttps://github.com/zhouxiaoka/autoclip ↩ 回到正文 · back to text
- 61 bendlang/bendhttps://github.com/bendlang/bend ↩ 回到正文 · back to text
- 62 Jakubantalik/thinking-orbshttps://github.com/Jakubantalik/thinking-orbs ↩ 回到正文 · back to text
- 63 mainmatter/100-exercises-to-learn-rusthttps://github.com/mainmatter/100-exercises-to-learn-rust ↩ 回到正文 · back to text
- 64 Diolinux/PhotoGIMPhttps://github.com/Diolinux/PhotoGIMP ↩ 回到正文 · back to text
- 65 clash-verge-rev/clash-verge-revhttps://github.com/clash-verge-rev/clash-verge-rev ↩ 回到正文 · back to text