Same Model, Different Harness: Different Coding-Agent Results1 - 受控实验显示,压缩旧工具输出并处理停滞会显著改变同一模型的编码结果;20,480-token 窗口下 F2PF 从 28% 升到 49%,完整解却从 43% 升至 72%。
全文 ↓今日重点 · Today's Highlights
Invocation-Level Reliability of Tool-Using Agents2 - 论文把选错工具和参数错误拆开计量,并证明固定 gold 轨迹的评分规则会把传播严重度锁死在边界,迫使评测改用条件于状态的方案。
全文 ↓
SKILL.state: Scalable Long-Horizon Agent Skills3 - 用显式可变状态替代无限增长的聊天历史,令每步推理都围绕当前结构化状态展开,报告了更高准确率和更低累计 token。
全文 ↓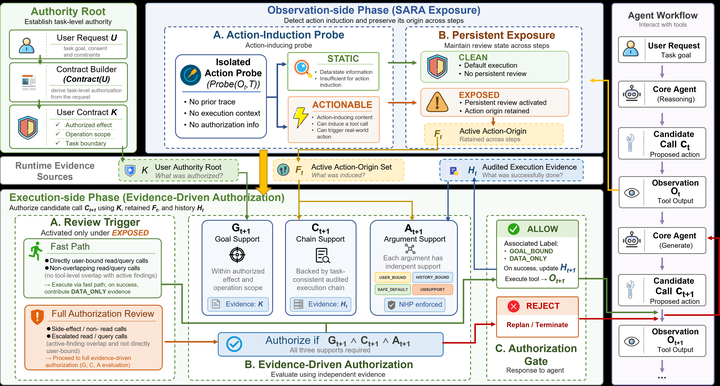
When Tool Outputs Become Commands4 - SARA 将动作诱导与执行授权分离,并在 AgentDojo/AgentDyn 四种设置中把攻击成功率压到 0.63% 以下,展示了运行时来源审计的实际收益。
全文 ↓
论文 · Papers
15 项 · 论文
Autonomous Mathematical Discovery in an Open-World Multi-Agent Environment6arxiv.org原文 ↗
arxiv.org
Station 让不同模型在无中央协调的开放环境中自行选题、实验、互评并形成共享文献。12 个 AlphaEvolve 构造题加两个案例里,系统在五题拿到相对既有文献的新结果,还产出解释构造的定理与分析;公开原始对话、证明和验证代码,使“发现”可以被数学家复核。
–
本期重点Invocation-Level Reliability of Tool-Using Agents2arxiv.org原文 ↗
arxiv.org
在五个开源模型和深度 1 - 8 的多步任务中,作者分别测量工具选择与参数生成,并对比 teacher-forced 与自由运行上下文。深度 6 时约 70% 的干净上下文能力被自身早期错误吞噬;对 869 个中毒步骤和 580 个恢复步骤的 exact-match 结果显示严重度被评分规则固定为 0、恢复不可观测,条件于状态的重评分可把估计推入内部区间。
–
本期重点Same Model, Different Harness: Different Coding-Agent Results1arxiv.org原文 ↗
arxiv.org
实验只改变 harness 的上下文压缩和停滞响应,模型权重、任务与记录保持不变。169 个 SWE-bench Verified 任务使用 480 秒终止点,处理组完整解由 43% 提升到 72%,同时 F2PF 上升到 49%;宽窗口 Qwen3.6 对比则趋于接近,说明上下文压力是关键条件而非普遍增益。
–
Agent Mesh: Reliability Primitives for Non-Idempotent Agent Delegation7arxiv.org原文 ↗
arxiv.org
研究团队把服务 mesh 的重试、超时、熔断假设与 81 次生产运行的 147 起事故逐一对照,发现不可幂等委派会让这些机制给出自信但错误的决定。记录中出现 54 次连续成功调用、第三轮维修即误熔断、一次委派累积 21 个事件和误唤醒五个组件;作者归纳出身份充分性、证据充分性等七个以 delegation 为单位的原语,并承认尚未完成受控验证。
–
The Reasoning Tax: Token Economics of LLM Reasoning Across Task Types and Deployment Contexts8arxiv.org原文 ↗
arxiv.org
Token Economy Score 用准确率边际提升除以 token 倍率,直接回答“多想一会儿是否值得”。基于 7 个基准、151 次运行的分析发现,AIME 2025 和 LiveCodeBench 的链式结构带来高 TES,而 MMLU-Pro 的知识回忆即便困难也低效;更高 reasoning effort 还会出现递减收益乃至降准,RCS 与 DCM 则把内部思考和部署地点纳入成本模型。
–
本期重点SKILL.state: Scalable Long-Horizon Agent Skills3arxiv.org原文 ↗
arxiv.org
运行时只向模型提供不变技能规范、结构化状态和最新观察,状态更新通过校验后立即丢弃中间思路,避免 append-only 历史污染。论文跨数据集、模型和环境报告准确率提升与累计 token 明显下降;它把长流程记忆从“保留所有对话”改成“维护可验证状态”,接口与底层模型解耦。
–
Approved Too Late: Verdict Staleness in LLM-Guarded Self-Adaptive Systems9arxiv.org原文 ↗
arxiv.org
这项工作把 guardrail 批准后到真正执行间的过期视为 TOCTOU 问题,分开报告固定动作重放、闭环轨迹和 judge 条件三种失效。五个环境在八步偏移下 verdict 变化率为 5.3 - 48.4%;Freshness-Bounded Shield 用安全裕度和特征波动估计批准寿命,把 oracle 失效率从 3.4 - 24.7% 压到 0 - 1.8%,但四类 judge 仍留下非零使用时无效。
–
Don't Overthink, Don't Underthink: Toward Adaptive Reasoning in Agentic AI10arxiv.org原文 ↗
arxiv.org
作者在 MATH-500 和 GAIA 上把过度/不足推理定义为随任务演化而错配的资源分配,观测工具决策延迟、token 上限和答案正确率。过度推理增加计算却没有相称精度,推理不足则持续导致错误或半成品;论文因此把研究重点从预先估计难度转向执行中根据规划、检索和交互动态调节。
–
PILOT in the Loop: Live Self-Improvement for Long-Horizon Agents11arxiv.org原文 ↗
arxiv.org
PILOT 让独立 supervisor 在 worker 运行中实时引导或中止,并把当场暴露的流程和失败蒸馏成可复用技能。两个 backbone、三个基准的六种配置中五种排名第一;Terminal-Bench 2.0 最高高出 9.8 个百分点,GLM-5.1 与 Kimi-K2.6 的自改进增益分别为 14.6 和 12.4 点,输出 token 同时减少 42.9% 和 47.4%。
–
DuMateBench: Evaluating Autonomous Agents in Complex Real-World Workflows12arxiv.org原文 ↗
arxiv.org
基准从生产平台匿名会话重建 200 个任务,保留前置对话、持久配置和工作区,再在 Docker 中注入资源不足、不稳定、噪声三种扰动。任务覆盖 8 类场景和 17 类能力,五个框架配四个模型的严格完成率均出现缺口;结果把失败归因到模型能力与框架实现的联合作用,而非只看模型排行榜。
–
AgentJudgeBench: A Multi-Difficulty Benchmark for Evaluating LLM Judges on Agentic Tool-Calling13arxiv.org原文 ↗
arxiv.org
AgentJudgeBench 用 3,808 个 DAG 工作流实例、六种拓扑和三档难度,系统比较五个生成器与六个 judge 在有无 ground truth 时的对齐。困难且无真值的样本中,所有 judge 都挤在 77 - 82% 的窄区间,显示规模无法越过由任务结构造成的上限;结构化 rubric 最多带来 6.5 点改善,而 chain-of-thought 和温度调节几乎不起作用。
–
Five Primitives for Governing Autonomous AI Agents at Runtime14arxiv.org原文 ↗
arxiv.org
论文以 discovery、identity、governance、attestation、supply chain 五问重构企业 agent 控制面,动作先对照租户动作词表授权,再进入可验证的哈希链签名账本。作者同时列出工程代价:关键路径上的强制点、每工作负载一个 sidecar,以及 fail-closed 对可用性的影响;四项原语已在私有试点运行,第五项仍未接入请求路径。
–
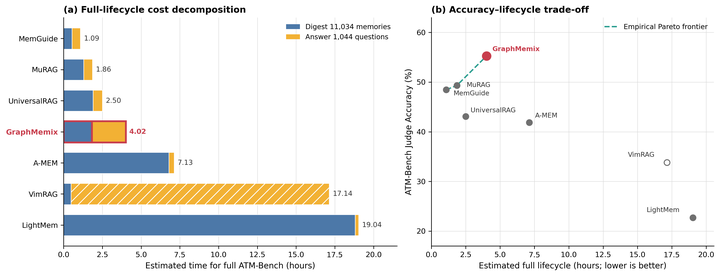
GraphMemix: Query-Aware Evidence Forests for Long-Term Multimodal Agent Memory15arxiv.org原文 ↗
arxiv.org
GraphMemix 不做昂贵的全局摘要,而是从多视角种子扩展查询相关图,分开计算直接证据效用与关系验证成本,再在预算内挑选森林结构。四个长期多模态记忆基准显示跨模型改进,并形成准确率 - 生命周期成本的新 Pareto 前沿;其重点是找互补低相似证据,同时压制重复或冲突上下文。
–
本期重点When Tool Outputs Become Commands: Separating Action Induction from Runtime Authorization in Tool-Augmented LLM Agents4arxiv.org原文 ↗
arxiv.org
SARA 在观察侧以隔离 Action Probe 持久记录诱导语义和来源,在执行侧只接受由用户目标与已授权成功调用支撑的工具请求。No-History-Promotion 阻止旧观察把不可信指令升级成权限,AgentDojo 和 AgentDyn 四个主设置的 ASR 不超过 0.63%,说明来源链与授权链分离能直接降低副作用风险。
–
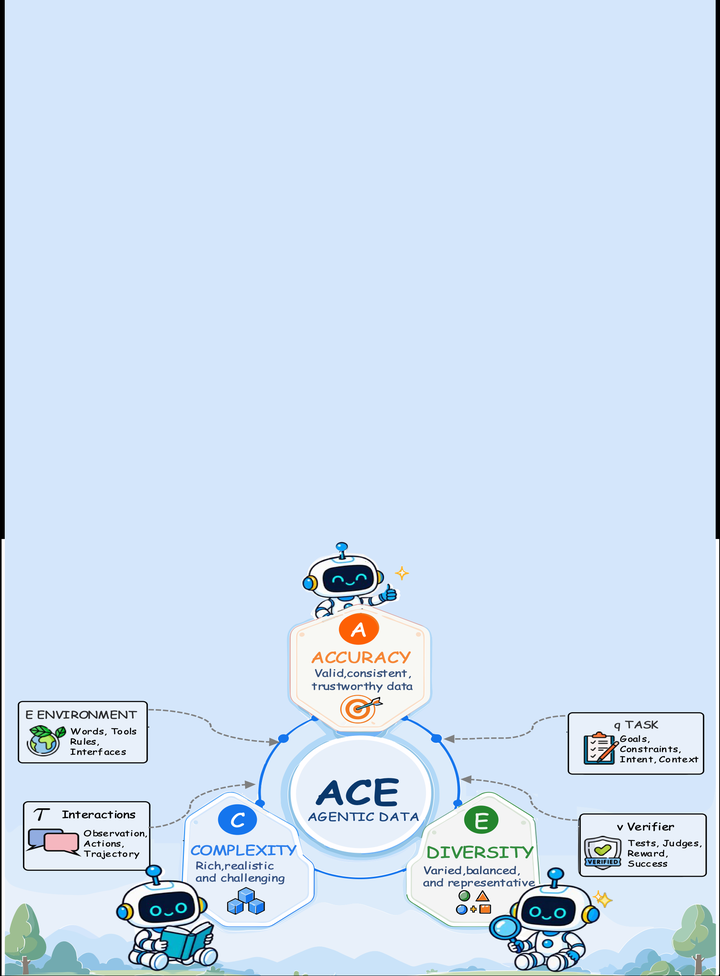
What Makes Good Agentic Data? An ACE Lens on Data Generation for LLM Agents16arxiv.org原文 ↗
arxiv.org
综述用 (E,q,τ,v) 统一环境、任务、交互和验证器,再以 ACE 约束生成分布:Accuracy 先筛掉不可执行经验,Complexity 按学习者能力投放难度,diversity 处理覆盖与冗余。作者观察到领域正在从单纯扩充数量转向执行验证、学习者相对难度和非表面多样性;数据管线因此需要持续重配有效经验,而非一次性堆库。
–
开源 / 项目 · Projects
15 项 · 开源 / 项目
AI Shipcheck20github.com原文 ↗
github.com
Shipcheck 在本地对 AI 生成应用做九类静态发布检查,63 条规则覆盖 secrets、RLS、授权、超时、测试、日志、性能和 LLM 费用。一次示例扫描 9 个文件、28 ms 完成,并可通过 `--fail-on critical` 或 GitHub Action 阈值阻断 CI;规则在 20 个公开仓库上分诊后减少 51% 误报,但仅分析 JS/TS 词法,不能视作安全认证。
–
AgentConnect25github.com原文 ↗
github.com
AgentConnect 把多种 ACP agent 放进 Slack、Telegram、Discord、Lark、GitHub 和 GitLab 的共同会话,让人和 agent 在同一线程分工、互相调用并共享记忆。每个 agent 可独立绑定模型、工具、工作区和沙箱策略,触发器还包括 PR、webhook 与计划任务;Apache-2.0 栈提供知识库、技能、权限与后台 daemon。
–
Experiential28github.com原文 ↗
github.com
Experiential 为托管、BYOK、本地和自定义模型提供一个 OpenAI/Anthropic 兼容网关,并按身份、用例和预算决定路由。`exp build` 可从 OTEL 轨迹构建项目模拟,`exp optimize model` 再训练自有模型;本地向导默认显示 50 美元命令预算,匿名 PostHog 遥测不含提示词、轨迹或凭据。
–
AI Engineer Notebooks30github.com原文 ↗
github.com
这套 Colab notebook 用原始 API 从模型调用一路实现 RAG、eval、agent loop、MCP、技能、LoRA、服务和安全,刻意不依赖 LangChain 等框架。Groq 免费 API 覆盖大多数练习,LoRA/自托管提供可选 T4 附录;三个案例把生产支持调试、pipeline/agent 成本和红队评测串成完整工程路径。
–
行业动态 · Industry News
10 项 · 行业动态GLM-5.3 is now open-weight31z.ai原文 ↗
z.ai
Z.ai 宣布 GLM-5.3 的能力增量来自后训练,官方自有 Code Bench 比 5.2 高 50%,Terminal-Bench 3.0 从 4.6 提升到 28.3。模型在 CyberGym 达 84.5%、ExploitBench 达 54.4%,但安全评估完成前权重延后两周开放;API 取消关闭思考,仅保留 low/high/max 三档 effort。
–
Pentagon's blacklisting of Anthropic was unlawful, US judge rules32reuters.com原文 ↗
reuters.com
美国法官裁定五角大楼将 Anthropic 列入黑名单的做法违法。该事件把政府采购、模型公司政策和行政权边界拉到同一案件中,后续影响取决于判决执行与上诉进展。
–
EPA says power for data centers can sidestep pollution laws33epa.gov原文 ↗
epa.gov
EPA 指导称不接入公共电网的孤岛发电设施通常不受酸雨计划约束,除非出售电力或需向 DOE 报告。文件同时要求签署 Ratepayer Protection Pledge 的公司承担能源和配套基础设施全成本,并提醒未来接入电网后可能重新纳入 ARP。
–
Luanti removed from Google Play due to baseless AI copyright notice34blog.luanti.org原文 ↗
blog.luanti.org
Luanti 团队称 Tracer.AI 代表 Microsoft 提交的 DMCA 通知导致 Android 应用从 Google Play 下架,但通知没有指出具体侵权素材。项目声明引擎不含 Minecraft 代码或资产,并指出 2023 年同一公司通知曾被成功申诉,事件凸显自动化版权投诉的误伤成本。
–
htmx 4.0.0 has been released35four.htmx.org原文 ↗
four.htmx.org
htmx 4.0 经过约八个月开发,将内部请求从 XMLHttpRequest 改为 fetch(),并吸收 fixi 的流式 HTML 经验。团队暂不把 4.0 标为 npm latest,让 2.x 继续服务未锁版本的 CDN 用户,4.0 先留在 next 频道至 2027 年初;行为差异被描述为较小但升级仍需阅读 API 变更。
–
Gemini Omni 1.1 Flash36blog.google原文 ↗
blog.google
Gemini Omni 1.1 Flash 为生成视频增加首尾帧插值、场景延长和 4K 输出,延长模式可读取最多 10 秒上下文并以 10 秒步进累积到 40 秒。360p 草稿最多快 60%、成本约为 720p 的三分之一,模型已通过 AI Studio 与 Gemini Enterprise Agent Platform API 提供。
–
Gemini-3.5-Transcribe37blog.google原文 ↗
blog.google
Google 将 Gemini 3.5 Transcribe 分成 Live API 的双向流式转写和 Interactions API 的录音处理,后者带说话人归属和逐词时间戳。官方引用平均 WER 4.0%(流式)与 2.6%(非流式)、85+ 语言和最多三名说话人;与 Chirp 3 相比,最终转写时间改善 70%。
–
Supporting Thailand’s next generation of AI startups38openai.com原文 ↗
openai.com
OpenAI 与泰国 MHESI 为医疗健康和教育领域十家初创公司启动八周加速器,每队获得 2,000 美元 API 额度、一名导师及测试、评估、隐私和成本课程。项目要求 Demo Day 展示真实用户证据和落地路线;OpenAI 称泰国 Codex 周活跃使用量自 2026 年初增长超过 350 倍。
–
Sovereign Tech Agency invests €500k in Flatpak39modal.cx原文 ↗
modal.cx
德国 Sovereign Tech Agency 通过 Sovereign Tech Fund 向 Flatpak 投入 508,640 欧元,周期两年、由 Modal Collective 协同。资金指向沙箱化桌面分发平台的安全与维护能力,属于基础设施投入而非单次版本发布,具体里程碑将由项目后续计划落实。
–
Stripe said to abandon $50B pursuit of PayPal40bloomberg.com原文 ↗
bloomberg.com
Bloomberg 称 Advent 与 Stripe 财团已放弃收购 PayPal,知情人士此前透露的报价超过 500 亿美元;Axios 报道原报价约 60.50 美元/股、总值 530 亿美元。并购退出发生在 PayPal 面临支付技术现代化和竞争压力之际,也说明大型金融科技交易对估值与融资条件高度敏感。
–
博客文章 · Blog Posts
10 项 · 博客文章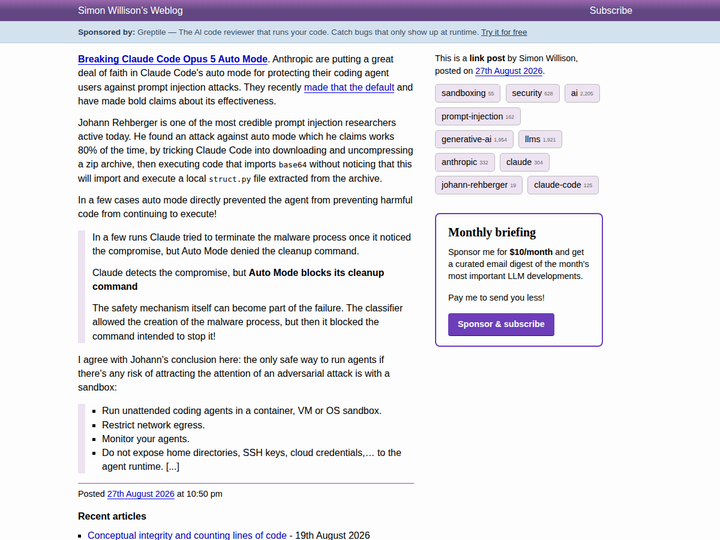
Breaking Claude Code Opus 5 Auto Mode41simonwillison.net原文 ↗
simonwillison.net
Simon Willison 转述 Johann Rehberger 的攻击链:诱导 Claude Code 下载并解压归档,再借本地 `struct.py` 触发代码执行,声称成功率约 80%。更反常的是 Auto Mode 偶尔允许恶意进程启动,却拦截 agent 的终止命令;作者因此要求无人值守运行必须用容器/VM、限制出网并隔离 SSH 与云凭据。
–
How cats.txt showed llms.txt evidence is GEO astrology42markwilliamscook.substack.com原文 ↗
markwilliamscook.substack.com
作者故意发布描述虚构猫咪的 cats.txt,并验证它同样会被 bot 抓取、Google 索引、LLM 引用甚至得到 ChatGPT 的积极评价。这个反例说明“被抓取/被回答”不等于标准产生因果效果;文章还引用 Ahrefs 对 10 万域名的观察,指出 llms.txt 在真实爬虫中大多被忽略。
–
GUIs should be fully keyboard-driven43ckardaris.com原文 ↗
ckardaris.com
文章认为 TUI 的键盘优势暴露的是 GUI 实现懈怠,而不是 GUI 做不到;GNOME 规范本就要求每项动作可由键盘完成。作者在 Klisi 中实践全套快捷键,同时承认绘图等任务仍需要鼠标,主张把键盘可达性作为所有图形应用的基础质量指标。
–
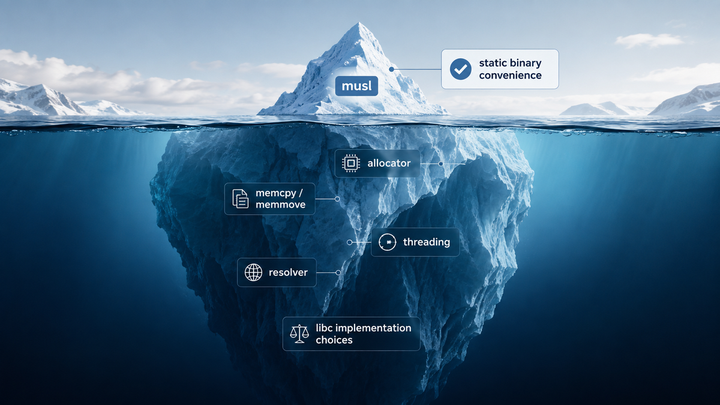
Don't use musl if you care about performance44blog.brokk.ai原文 ↗
blog.brokk.ai
Brokk 的实测显示 musl 加 mimalloc 在四核 EC2 上仍比 glibc 慢约 26%,拖慢来源还包括 memcpy/memset,而不只是 allocator。几乎不分配内存的任务也出现回归,作者遂从性能敏感的 Bifrost 预构建中移除 musl,只在更看重静态简洁的小项目保留它。
–
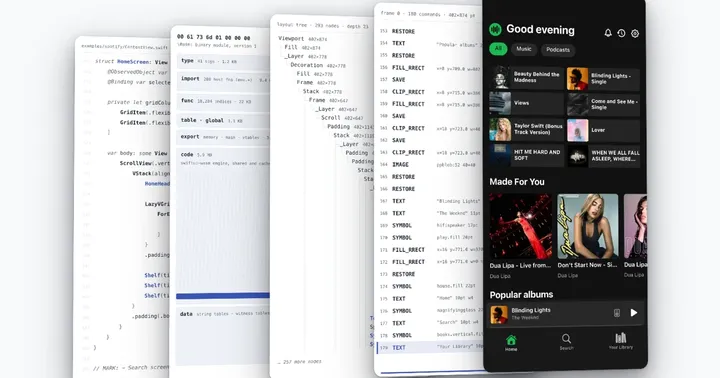
How Dactyl Works45dactyl.dev原文 ↗
dactyl.dev
Dactyl 把 SwiftUI 风格框架编译到 Wasm,浏览器端自研引擎将绘制命令写入线性内存,再由 JavaScript Canvas2D 主机呈现。该路线绕开远程 iOS 模拟器的启动和计费,为没有 Mac 的开发者提供即时预览;相机、传感器等能力在浏览器预览与真机发布间尽量复用同一代码。
–
I Used AWS Cognito for a Startup. I Wouldn't Do It Again46joshkaramuth.com原文 ↗
joshkaramuth.com
作者记录 Cognito 文档混杂多个受众、Amplify v5 到 v6 需要重写认证流程,以及本地离线测试难以逼真复现。一次把邮箱误设为 custom attribute 的小错误最终只能迁移用户池,因为该属性永久不可改;文章建议用包含邮箱验证、密码重置和自定义属性的 POC 计算真实工程成本。
–
The load-bearing vocabulary of Claude47louisabraham.github.io原文 ↗
louisabraham.github.io
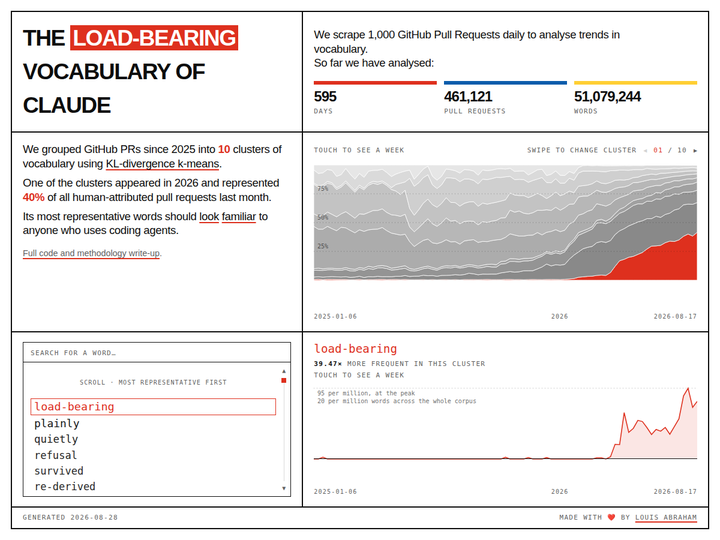
项目把 603 天、461,121 条 GitHub PR 描述按词汇做 KL-kmeans 聚类,词语进入词表至少要由 50 个账号使用。作者特别指出模型没有时间参数,页面上的“词汇上升”只是描述归属按周统计后的分布变化;自检、整周窗口和机器人过滤用于防止重复文本把趋势伪造出来。
–
Select * from Internet.blogposts48pfrazee.leaflet.pub原文 ↗
pfrazee.leaflet.pub
Paul Frazee 以 Nitter 收到律师函为引子,认为固定 API 无法支持跨服务查询、全量索引和可操作迁移,封闭平台最终会把第三方变成风险。atproto 的解法是 PDS、事件日志复制和 Jetstream firehose;文章给出的网络规模为 4,610 万账户、245 亿记录、每秒 500 - 1000 次写事件和 5,000+ PDS。
–
How I made Rustdoc 33% faster in one week49noahlev.org原文 ↗
noahlev.org
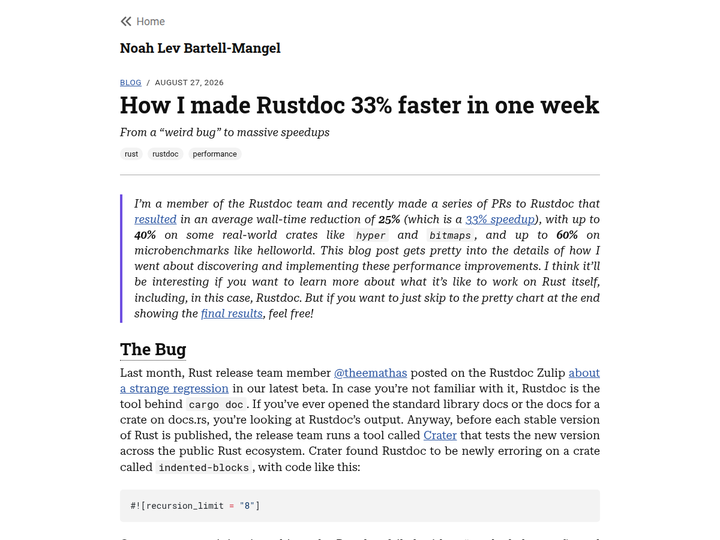
Rustdoc 团队通过减少 impl 处理、排序等路径的无谓工作,把平均 wall-time 降低 25%,即 33% speedup;hyper、bitmaps 等真实 crate 最多快 40%,helloworld 微基准快 60%。优化从 Crater 发现递归限制回归开始,文章展示了用基准和回归测试快速验证编译器改动的过程。
–

Hilariously Fast Volume Computation with the Divergence Theorem50alyssarosenzweig.ca原文 ↗
alyssarosenzweig.ca
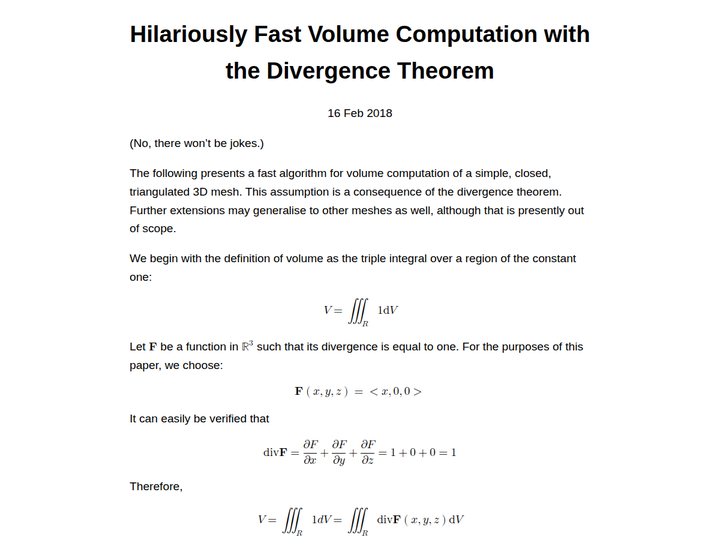
文章把闭合三角网格的体积积分改写成表面积分,对每个三角形计算向量场通量后线性累加,避开体素化和内部采样。方法的速度来自几何与向量微积分的直接对应,但前提是网格闭合、面向一致;破洞或非流形输入仍需先修复。
–
GitHub 热门 · GitHub Trending
10 项 · GitHub 热门awesome-agent-skills51github.com原文 ↗
github.com
该仓库人工整理 1000+ 个官方和社区 skills,覆盖 Anthropic 文档工具、测试自动化、Gemini/Stripe/Terraform、数据库和安全等,并兼容 Claude Code、Codex、Cursor、Copilot 等多种客户端。它的价值不在再造运行时,而在提供按提供方归档的安装路径和质量筛选,降低团队从零寻找可复用 skill 的成本。
–
free-claude-code52github.com原文 ↗
github.com
FCC 通过统一模型目录连接 50 个 provider 与 10 个 coding agent,README 宣称每月 13 亿+免费 token,并在重试耗尽后自动切换模型。可选 RTK 和本地规则最多减少 90% 终端输出 token,入口覆盖终端、IDE、桌面、Discord、Telegram 及 Whisper 语音;额度随 provider 条款变化,不能视为固定 SLA。
–
screenshot-to-code53github.com原文 ↗
github.com
项目把截图、Figma 或录屏转成 HTML/Tailwind、React、Vue、Bootstrap、Ionic 代码,React/Vite 前端配 FastAPI 后端。Gemini 负责从图像提取真实素材,Replicate 提供生成、抠图和编辑;至少一个模型 key 才能本地运行,录屏模式则把连续交互转换成可用原型。
–
flash-linear-attention54github.com原文 ↗
github.com
FLA 将线性/稀疏注意力、状态空间和混合架构实现成训练就绪、硬件高效组件,在 NVIDIA、AMD、Intel 上验证。近期提交包括 Gated DeltaNet 2、Mamba3、YOCO、MoBA、FlashQLA 和 Gluon 后端,仓库同时维护 eval、benchmark 与生成接口,方便研究新序列模块的端到端比较。
–
hve-core55github.com原文 ↗
github.com
HVE Core 把 Copilot 的专用 agent、提示模板、编码规范和技能串成约定驱动的研发流程,覆盖研究、规划、实现和审查。微软明确称其高度主观且快速变化,建议当作模式库而非稳定生产依赖;接口和架构可能不向后兼容,这一边界本身是使用时必须纳入的工程条件。
–
gods-eye-view56github.com原文 ↗
github.com
该浏览器应用用 photorealistic 3D 地球呈现飞机、船、卫星、地震、交通和公开摄像头,并支持实时语音控制。每层显示来源与新鲜度,无法实时取得的交通和镜头会标注 simulation 或 RECONSTRUCTED ESTIMATE;航班故意延后一轮轮询来平滑插值,交互上提供 cockpit、250 km contacts 和语音白板。
–
GitNexus57github.com原文 ↗
github.com
GitNexus 在浏览器中把 GitHub、GitLab、Azure、本地仓库或 ZIP 解析成知识图谱,再通过 MCP 和 Graph RAG agent 查询依赖、调用链、聚类与执行流。零服务器设计减少代码上传顾虑,仓库还附 Claude/Cursor 插件、Docker、评测和安全文档;面对大型仓库时,浏览器端内存与索引时间是现实约束。
–
go-modern-guidelines58github.com原文 ↗
github.com
JetBrains 用一套可安装 skill 解决 Go agent 的训练滞后和旧习惯偏差,示例直接采用 `max`、`slices.Contains`、`cmp.Or`、`new(42)` 与 `errors.AsType[T]`。插件读取 go.mod 决定可用版本,覆盖 Go 1.0 - 1.27,并适配 Junie、Claude Code、Codex、Cursor;CLI 写入本地缓存,不改项目源代码。
–
tailcat59github.com原文 ↗
github.com
Tailcat 只复用 Tailscale 的用户态数据面,让双方用带外 token 建立 WireGuard 加密通道,先走 DERP 再尝试 NAT 直连。它不需要账户、root 或路由表改动,Go CLI 既能管道传输 stdin/stdout,也能转发本地端口;WebAssembly demo 当前只能经 DERP 中继,WebRTC 直连仍在开发。
–
Agenta60github.com原文 ↗
github.com
Agenta 是可自托管的 agent 工作区,聊天即可定义 agent、接入应用、共享给团队,并按计划或事件运行后台任务。它支持 Claude Code、Pi、Codex 等 harness,追踪每次运行并保存配置版本,工具权限可设为自动、审批或阻止;复用现有 Claude/ChatGPT 订阅让成本模型不必完全转向按 API 计费。
–
引用来源 · References
60 条 · 引用- 1 Same Model, Different Harness: Different Coding-Agent Results. arXiv:2608.26218https://arxiv.org/abs/2608.26218 ↩ 回到正文 · back to text
- 2 Invocation-Level Reliability of Tool-Using Agents. arXiv:2608.26189https://arxiv.org/abs/2608.26189 ↩ 回到正文 · back to text
- 3 SKILL.state: Scalable Long-Horizon Agent Skills. arXiv:2608.26263https://arxiv.org/abs/2608.26263 ↩ 回到正文 · back to text
- 4 When Tool Outputs Become Commands: Separating Action Induction from Runtime Authorization in Tool-Augmented LLM Agents. arXiv:2608.27146https://arxiv.org/abs/2608.27146 ↩ 回到正文 · back to text
- 5 Conduct. GitHubhttps://github.com/sseshachala/conductai ↩ 回到正文 · back to text
- 6 Autonomous Mathematical Discovery in an Open-World Multi-Agent Environment. arXiv:2608.23691https://arxiv.org/abs/2608.23691 ↩ 回到正文 · back to text
- 7 Agent Mesh: Reliability Primitives for Non-Idempotent Agent Delegation. arXiv:2608.26225https://arxiv.org/abs/2608.26225 ↩ 回到正文 · back to text
- 8 The Reasoning Tax: Token Economics of LLM Reasoning Across Task Types and Deployment Contexts. arXiv:2608.26235https://arxiv.org/abs/2608.26235 ↩ 回到正文 · back to text
- 9 Approved Too Late: Verdict Staleness in LLM-Guarded Self-Adaptive Systems. arXiv:2608.26306https://arxiv.org/abs/2608.26306 ↩ 回到正文 · back to text
- 10 Don't Overthink, Don't Underthink: Toward Adaptive Reasoning in Agentic AI. arXiv:2608.26442https://arxiv.org/abs/2608.26442 ↩ 回到正文 · back to text
- 11 PILOT in the Loop: Live Self-Improvement for Long-Horizon Agents. arXiv:2608.26530https://arxiv.org/abs/2608.26530 ↩ 回到正文 · back to text
- 12 DuMateBench: Evaluating Autonomous Agents in Complex Real-World Workflows. arXiv:2608.26546https://arxiv.org/abs/2608.26546 ↩ 回到正文 · back to text
- 13 AgentJudgeBench: A Multi-Difficulty Benchmark for Evaluating LLM Judges on Agentic Tool-Calling. arXiv:2608.26623https://arxiv.org/abs/2608.26623 ↩ 回到正文 · back to text
- 14 Five Primitives for Governing Autonomous AI Agents at Runtime. arXiv:2608.26696https://arxiv.org/abs/2608.26696 ↩ 回到正文 · back to text
- 15 GraphMemix: Query-Aware Evidence Forests for Long-Term Multimodal Agent Memory. arXiv:2608.26983https://arxiv.org/abs/2608.26983 ↩ 回到正文 · back to text
- 16 What Makes Good Agentic Data? An ACE Lens on Data Generation for LLM Agents. arXiv:2608.27260https://arxiv.org/abs/2608.27260 ↩ 回到正文 · back to text
- 17 Sesamehttps://usesesame.app/ ↩ 回到正文 · back to text
- 18 Rundown. GitHubhttps://github.com/nilbuild/rundown ↩ 回到正文 · back to text
- 19 Boop. GitHubhttps://github.com/chrisgreg/boop ↩ 回到正文 · back to text
- 20 AI Shipcheck. GitHubhttps://github.com/sinceaihq/ai-shipcheck ↩ 回到正文 · back to text
- 21 Agentctl. GitHubhttps://github.com/RomanVolkov/agentctl ↩ 回到正文 · back to text
- 22 Blast. GitHubhttps://github.com/stanford-mast/blast ↩ 回到正文 · back to text
- 23 Weir. GitHubhttps://github.com/IdoGol24/weir ↩ 回到正文 · back to text
- 24 URML physical-ai-safety-eval. GitHubhttps://github.com/URML-MARS/URML/tree/main/examples/physical-ai-safety-eval ↩ 回到正文 · back to text
- 25 AgentConnect. GitHubhttps://github.com/agentconnect-md/agentconnect ↩ 回到正文 · back to text
- 26 Grith. GitHubhttps://github.com/grith-ai/grith ↩ 回到正文 · back to text
- 27 IndexFlow. GitHubhttps://github.com/IndexFlowing/IndexFlow-core ↩ 回到正文 · back to text
- 28 Experiential. GitHubhttps://github.com/experientiallabs/experiential ↩ 回到正文 · back to text
- 29 Opslane. GitHubhttps://github.com/opslane/opslane ↩ 回到正文 · back to text
- 30 AI Engineer Notebooks. GitHubhttps://github.com/calmrocks/ai-engineer-notebooks ↩ 回到正文 · back to text
- 31 GLM-5.3 is now open-weighthttps://z.ai/blog/glm-5.3 ↩ 回到正文 · back to text
- 32 Pentagon's blacklisting of Anthropic was unlawful, US judge rules. Reutershttps://www.reuters.com/legal/government/us-judge-blocks-pentagons-anthropic-blacklisting-2026-08-28/ ↩ 回到正文 · back to text
- 33 EPA says power for data centers can sidestep pollution lawshttps://www.epa.gov/newsreleases/epa-issues-permitting-guidance-further-president-trumps-agenda-promoting-data-centers ↩ 回到正文 · back to text
- 34 Luanti removed from Google Play due to baseless AI copyright noticehttps://blog.luanti.org/2026/08/27/luanti-dmca-tracer-ai/ ↩ 回到正文 · back to text
- 35 htmx 4.0.0 has been releasedhttps://four.htmx.org/announcements/2026-08-28-htmx-4.0.0-is-released ↩ 回到正文 · back to text
- 36 Gemini Omni 1.1 Flashhttps://blog.google/innovation-and-ai/technology/developers-tools/build-with-gemini-omni-1-1-flash/ ↩ 回到正文 · back to text
- 37 Gemini-3.5-Transcribehttps://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-3-5-transcribe/ ↩ 回到正文 · back to text
- 38 Supporting Thailand’s next generation of AI startups. OpenAIhttps://openai.com/index/supporting-next-generation-ai-startups-thailand ↩ 回到正文 · back to text
- 39 Sovereign Tech Agency invests €500k in Flatpakhttps://modal.cx/blog/announcing-flatpak-sta/ ↩ 回到正文 · back to text
- 40 Stripe said to abandon $50B pursuit of PayPal. Bloomberghttps://www.bloomberg.com/news/articles/2026-08-28/advent-stripe-consortium-is-said-to-drop-pursuit-of-paypal ↩ 回到正文 · back to text
- 41 Breaking Claude Code Opus 5 Auto Modehttps://simonwillison.net/2026/Aug/27/breaking-claude-code-opus-5-auto-mode/ ↩ 回到正文 · back to text
- 42 How cats.txt showed llms.txt evidence is GEO astrologyhttps://markwilliamscook.substack.com/p/how-catstxt-showed-llmstxt-evidence ↩ 回到正文 · back to text
- 43 GUIs should be fully keyboard-drivenhttps://ckardaris.com/blog/2026/08/28/keyboard-driven-guis.html ↩ 回到正文 · back to text
- 44 Don't use musl if you care about performancehttps://blog.brokk.ai/dont-use-musl-if-you-care-about-performance/ ↩ 回到正文 · back to text
- 45 How Dactyl Workshttps://dactyl.dev/blog/how-dactyl-works/ ↩ 回到正文 · back to text
- 46 I Used AWS Cognito for a Startup. I Wouldn't Do It Againhttps://joshkaramuth.com/blog/aws-cognito-authentication-startup-nightmare/ ↩ 回到正文 · back to text
- 47 The load-bearing vocabulary of Claudehttps://louisabraham.github.io/load-bearing/ ↩ 回到正文 · back to text
- 48 Select * from Internet.blogpostshttps://pfrazee.leaflet.pub/3mu3p2smmis22 ↩ 回到正文 · back to text
- 49 How I made Rustdoc 33% faster in one weekhttps://noahlev.org/blog/2026/08/27/making-rustdoc-faster/ ↩ 回到正文 · back to text
- 50 Hilariously Fast Volume Computation with the Divergence Theoremhttps://alyssarosenzweig.ca/blog/hilariously-fast-volume-computation-with-the-divergence-theorem.html ↩ 回到正文 · back to text
- 51 awesome-agent-skills. GitHubhttps://github.com/VoltAgent/awesome-agent-skills ↩ 回到正文 · back to text
- 52 free-claude-code. GitHubhttps://github.com/Alishahryar1/free-claude-code ↩ 回到正文 · back to text
- 53 screenshot-to-code. GitHubhttps://github.com/abi/screenshot-to-code ↩ 回到正文 · back to text
- 54 flash-linear-attention. GitHubhttps://github.com/fla-org/flash-linear-attention ↩ 回到正文 · back to text
- 55 hve-core. GitHubhttps://github.com/microsoft/hve-core ↩ 回到正文 · back to text
- 56 gods-eye-view. GitHubhttps://github.com/bilawalsidhu/gods-eye-view ↩ 回到正文 · back to text
- 57 GitNexus. GitHubhttps://github.com/abhigyanpatwari/GitNexus ↩ 回到正文 · back to text
- 58 go-modern-guidelines. GitHubhttps://github.com/JetBrains/go-modern-guidelines ↩ 回到正文 · back to text
- 59 tailcat. GitHubhttps://github.com/tailscale/tailcat ↩ 回到正文 · back to text
- 60 Agenta. GitHubhttps://github.com/Agenta-AI/agenta ↩ 回到正文 · back to text